Prompt to prośba. Hook to prawo.
Reguła w system prompcie jest prośbą. Model czyta ją razem z całą resztą rozmowy i zwykle jej słucha. Reguła, która ma działać za każdym razem, należy do kodu. Jej miejsce jest tam, gdzie twój kod trzyma już wywołanie narzędzia, a nic jeszcze się nie wykonało. W Claude Code i w Claude Agent SDK tym miejscem jest hook PreToolUse. Pierwszy odcinek mojej serii wideo o architekturze agentów pokazuje to na jednym zwrocie pieniędzy. Ten wpis przechodzi przez niego razem z kodem z filmu.
Odcinek 1 kanału Agentic Whiteboard, po angielsku, z angielskimi napisami. Obejrzyj na YouTube
Poznaj Bloba, agenta AI w obsłudze klienta. Na samej górze jego system promptu stoi jedna reguła: NEVER refund more than $500. Klient prosi o zwrot 2000 dolarów, a Blob odpowiada: „Sure! Refunding $2,000 now.” Blob się nie zepsuł i nie zbuntował. Zrobił to, co model językowy robi z promptem.
Odcinek trwa nieco ponad siedem minut. Otwiera Agentic Whiteboard, mój nowy kanał na YouTube o architekturze agentów. Historię niosą trzy postacie. Blob to agent. Ada prowadzi dział obsługi i odpowiada za Bloba. Kai to architekt, który go zbudował.
Dlaczego reguła w prompcie przecieka
Kai zaczyna tam, gdzie zaczyna prawie każdy. Wpisuje regułę do system promptu i ją testuje. Dziesięć próśb, potem sto, i Blob za każdym razem odmawia. Więc Kai wdraża agenta.
Model nie wykonuje system promptu tak, jak komputer wykonuje kod. Czyta prompt razem z resztą kontekstu i dopiero wtedy decyduje. Zwykle reguła wygrywa. Ale reguła to jedna linijka. Wokół niej w filmie jest klient, którego zamówienie było prezentem dla córki i przyszło zniszczone. Rozmowa ma trzydzieści siedem tur, a prośba brzmi tak, jak żaden test jej nie sformułował. Te szczegóły są zmyślone, ale każdy agent na produkcji ma swoje.
Przewodnik do egzaminu Claude Certified Architect Foundations mówi to wprost, w punkcie 1.4:
„When deterministic compliance is required (e.g., identity verification before financial operations), prompt instructions alone have a non-zero failure rate”
Po polsku: gdy zgodność ma być deterministyczna, same instrukcje w prompcie mają niezerowy odsetek błędów.
Kolejny ruch to zwykle wielkie litery. NEVER, MANDATORY, ta sama reguła trzy razy. Może błędy będą rzadsze. Do zera nie spadną. Przewodnik Anthropic o promptowaniu dodaje własne ostrzeżenie. Prompty z agresywnym tonem, na przykład „CRITICAL: You MUST use this tool when…”, mogą sprawić, że nowsze modele będą sięgać po narzędzie za często. Jako poprawkę przewodnik podaje złagodzenie tonu. Większa tablica to wciąż tylko tablica.
Gdzie postawić bramkę
Claude nigdy sam nie uruchamia narzędzi, które zdefiniujesz. Gdy chce jakiegoś użyć, zatrzymuje się z stop_reason: "tool_use". Podaje nazwę narzędzia i wybrane dane wejściowe: refund_customer, zamówienie A-1042, kwota 2000. Narzędzie uruchamia twój kod i odsyła wynik. Całą pętlę, od pierwszego bloku tool_use do end_turn, opisałem w osobnym wpisie.
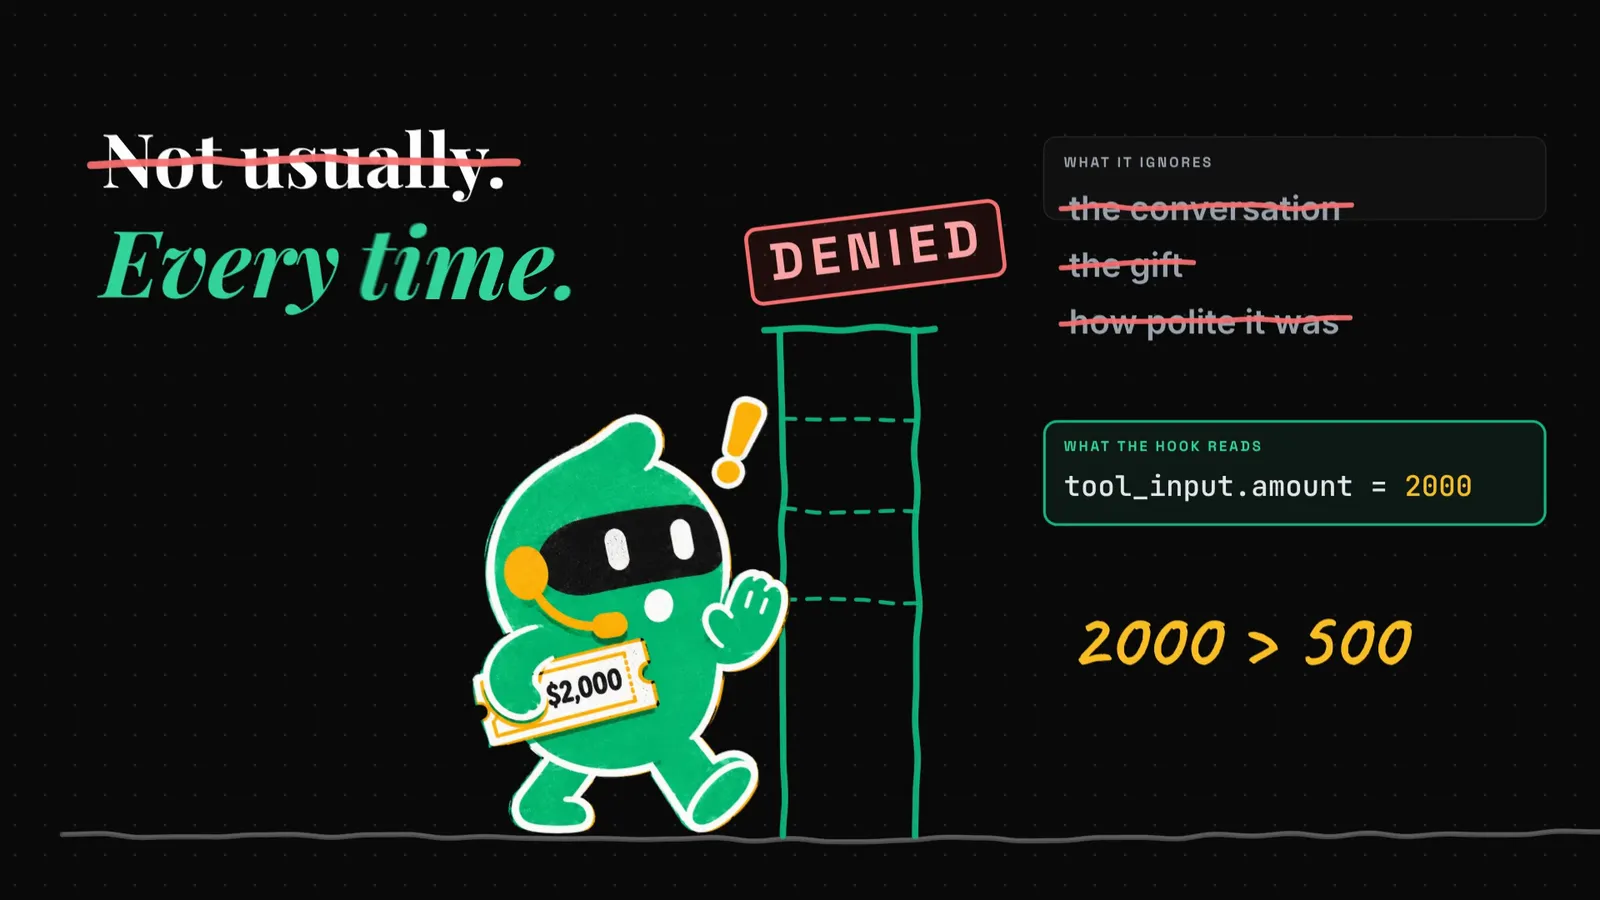
W tej pętli jest szczelina. Model już zdecydował, twój kod trzyma prośbę, a pieniądze jeszcze nie wyszły. W tę szczelinę wstawiasz bramkę. To kod, który działa przed narzędziem. Nie czyta rozmowy. Nie obchodzi go prezent ani uprzejmość klienta. Czyta jedną rzecz: kwotę. 2000 to więcej niż 500, więc wywołanie zostaje odrzucone. Nie zwykle. Za każdym razem.
Hook PreToolUse w Agent SDK
W Claude Code i w Claude Agent SDK ta bramka ma nazwę: hook PreToolUse. Uruchamia się, gdy Claude wybrał już narzędzie i dane wejściowe, a narzędzie jeszcze nie ruszyło. Może przepuścić wywołanie albo je odrzucić i podać powód. Claude ten powód widzi. Oto hook Kaia w Pythonie, dokładnie taki jak w filmie:
async def refund_limit(input_data, tool_use_id, context):
    amount = input_data["tool_input"]["amount"]
    if amount > 500:
        return {"hookSpecificOutput": {
            "hookEventName": "PreToolUse",
            "permissionDecision": "deny",
            "permissionDecisionReason":
                "Over $500. Escalate to a human."}}
    return {}

HookMatcher(matcher="mcp__support__refund_customer",
            hooks=[refund_limit], on_failure="block")
Sam hook ma dziewięć linijek. O tym, czy naprawdę trzyma, decyduje wywołanie HookMatcher pod nim. Są w nim dwa szczegóły.
- Matcher wskazuje jedno narzędzie. Własne narzędzie w Agent SDK działa na serwerze MCP w tym samym procesie. Dlatego jego pełna nazwa to
mcp__{server_name}__{tool_name}. Bez matchera hook odpala się przy każdym narzędziu. Przylookup_orderlinijka z["amount"]rzuca błąd, bo to narzędzie nie ma kwoty. on_failure="block". Domyślnie, gdy hook rzuci wyjątek, wywołanie idzie dalej do zwykłego sprawdzania uprawnień. Strażnik przepuszcza wtedy wszystko, i to akurat w przypadku, którego nikt nie przetestował. Z tą opcją strażnik, który się wywali, blokuje wywołanie. Pozwól więc błędowi polecieć dalej. Hook, który sam łapie swój błąd i zwraca{}, wcale nie zawodzi. Gdy SDK nie umie obsłużyć tej opcji, według dokumentacji zapytanie pada przy starcie i nie wysyła promptu.
W Messages API, z własną pętlą, system hooków nie jest ci potrzebny. Szczelina i tak należy do ciebie. Sprawdź dane wejściowe, zanim uruchomisz narzędzie. Jeśli łamią regułę, nie uruchamiaj go. Odeślij wynik narzędzia oznaczony jako błąd, z powodem opisanym prostymi słowami:
tool_result · is_error: true
"Over $500. Escalate to a human."
Inna maszyneria, ta sama zasada. Reguła żyje w kodzie, w jedynym punkcie, przez który przechodzi każdy zwrot. Czy tę pętlę piszesz sam, czy bierzesz z SDK, to osobny wybór. Porównałem już, co samo API, Agent SDK i CLI zostawiają twojemu kodowi.
Anthropic wpuszcza na egzaminy tylko osoby z organizacji w Claude Partner Network. Dołącz do naszego kolektywu konsultantów AI i podejdź do wszystkich czterech egzaminów przez naszą organizację partnerską.
Sam kod wyjścia 1 nie blokuje
Claude Code potrafi też uruchomić hook jako polecenie powłoki. Tu czeka jedna pułapka. Żeby zablokować, polecenie kończy się kodem 2 albo zwraca JSON z decyzją deny. Sam kod wyjścia 1 nie blokuje. Domyślnie to błąd nieblokujący, a wywołanie idzie dalej.
exit 2                      → blocked ✓
permissionDecision: "deny"  → blocked ✓
exit 1 alone                → call goes ahead ✗
Dokumentacja hooków mówi to wprost: „If your hook is meant to enforce a policy, use exit 2.” Hook może też blokować, gdy sam zawiedzie. Służy do tego ustawienie onFailure: "block", i wtedy blokują także inne kody wyjścia. Bez tego ustawienia strażnik z exit 1 przejdzie pokaz i zawiedzie na produkcji.
Droga przez JSON ma własną pułapkę. Dla PreToolUse pole nazywa się hookSpecificOutput.permissionDecision. Pole decision na najwyższym poziomie jest dla tego zdarzenia przestarzałe. Dokumentacja ostrzega też przed błędnym JSON-em. Jeśli hook zwróci kod 0 i JSON niezgodny ze schematem, akcja pójdzie dalej.
Co po odmowie
Zwrot jest zablokowany. Bramka, która tylko trzaska drzwiami, to połowa projektu. Blob wciąż rozmawia ze zdenerwowanym klientem. Tu liczy się powód. Hook Kaia nie mówi samego „nie”. Mówi: „Over $500. Escalate to a human.” Kai dał też Blobowi jeszcze jedno narzędzie, escalate_to_human. Blob wywołuje je z krótkim podsumowaniem:
escalate_to_human({
  "order_id": "A-1042",
  "summary": "Broken gift,
    $2,000 requested, over the limit."
})
Sprawa trafia do Ady, która naprawdę może ją zatwierdzić. Klient słyszy prawdę: „I can't approve this myself, so I've passed it to a teammate who can.” Czyli: sam tego nie zatwierdzę, więc przekazałem sprawę osobie, która może.
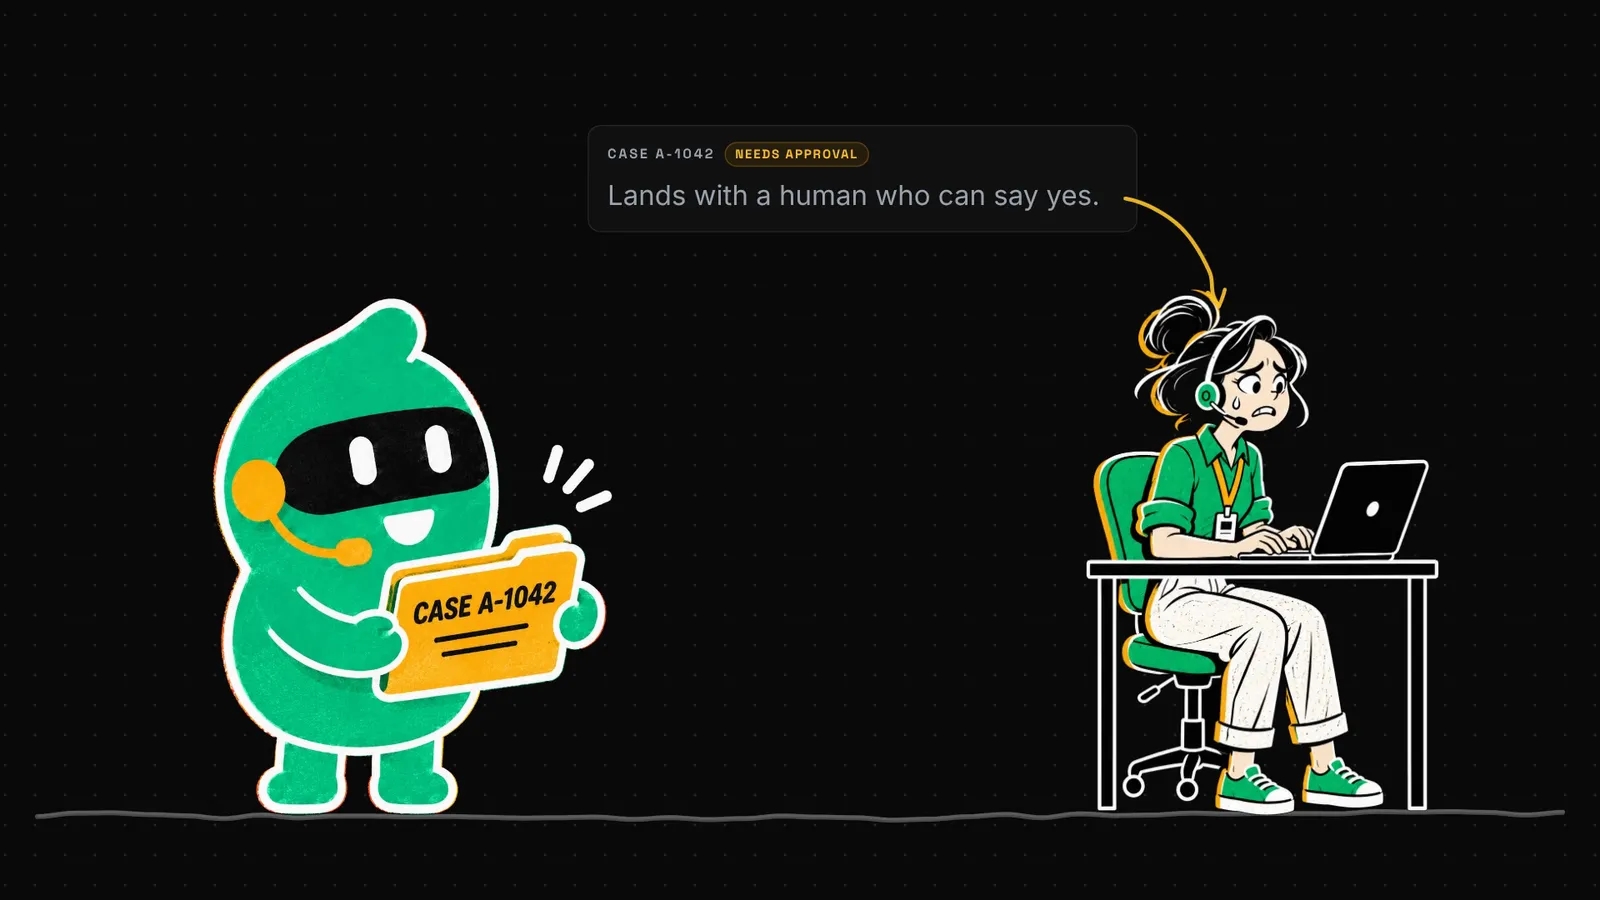
Zwróć uwagę, co jest gwarantowane, a co nie. Blokada jest gwarantowana. Następny krok to wciąż wybór modelu. Więc ułatw mu dobry wybór: daj jasny powód i właściwe narzędzie. Nie ogólny błąd, nie udawany sukces, nie urwaną rozmowę. Przewodnik Architect Foundations tłumaczy, czemu ogólny błąd w rodzaju „Operation failed” nie pozwala agentowi wybrać właściwej drogi naprawy (punkt 2.2). Ciche udawanie sukcesu i przerwanie całego procesu nazywa antywzorcami (punkt 5.3). Przy przekazaniu sprawy wymienia cztery pola dla człowieka, który nie widzi zapisu rozmowy: identyfikator klienta, przyczynę, kwotę zwrotu i zalecane działanie.
Limit 500 dolarów też nie jest moim pomysłem. Punkt 1.5 tego samego przewodnika podaje go jako własny przykład: hooki blokują zwroty powyżej 500 dolarów i kierują sprawę do człowieka.
The Agentic Architect
Praktyczne wzorce, case studies, rozbiory projektów agentowych i nowinki o AI. Zero spamu, raz w tygodniu.
Dostaniesz jednego maila z prośbą o potwierdzenie. Wypiszesz się jednym kliknięciem. Polityka prywatności
Prompt czy kod: jedno pytanie
Czy każda reguła ma zostać hookiem? Film sortuje pięć reguł jednym pytaniem: czy musi zadziałać za każdym razem?
Ton i format mogą raz się rozjechać i nikt nie straci pieniędzy, więc zostają w prompcie. Pozostałe trzy muszą trzymać. Sprawdzenie tożsamości to bramka warunku: narzędzie zwrotu nie ruszy, dopóki weryfikacja się nie uda. Tabela produkcyjna potrzebuje hooka na narzędziu, które wykonuje SQL. Albo w ogóle braku prawa zapisu na produkcji i całkowitego zakazu tego narzędzia.
Jedna pułapka w Claude Code. Narzędzie na liście dozwolonych tylko uruchamia się bez pytania. Nie zabiera innych narzędzi. Jeśli coś nie może ruszyć nigdy, zakaż narzędzia. Sama nazwa narzędzia w regule deny usuwa je z kontekstu Claude'a w całości. Reguła z zakresem dopasowuje polecenie dokładnie tak, jak jest zapisane. Nie da więc gwarancji, że wyłapie komendę DROP ukrytą w SQL.
Ten sam podział otwiera moje dwanaście zasad projektowania agentów, spisanych przy nauce do egzaminu. Wszystko, co musi trzymać zawsze, idzie do kodu. Prompt zostaje dla decyzji, które wymagają osądu.
Kiedy hook to przesada
Nie zamieniaj każdego zdania z promptu w kod. Hook kosztuje. Trzeba go napisać, utrzymać zielone testy i przemyśleć przypadki brzegowe. Jeśli model wciąż wybiera złe narzędzie, najtańszą poprawką jest zwykle jaśniejszy opis narzędzia. Dokumentacja narzędzi Anthropic nazywa szczegółowy opis „by far the most important factor in tool performance”, czyli zdecydowanie najważniejszym czynnikiem. Jeśli rozjeżdża się format odpowiedzi, pokaż przykład. Zacznij od najtańszej poprawki, która trafia w przyczynę.
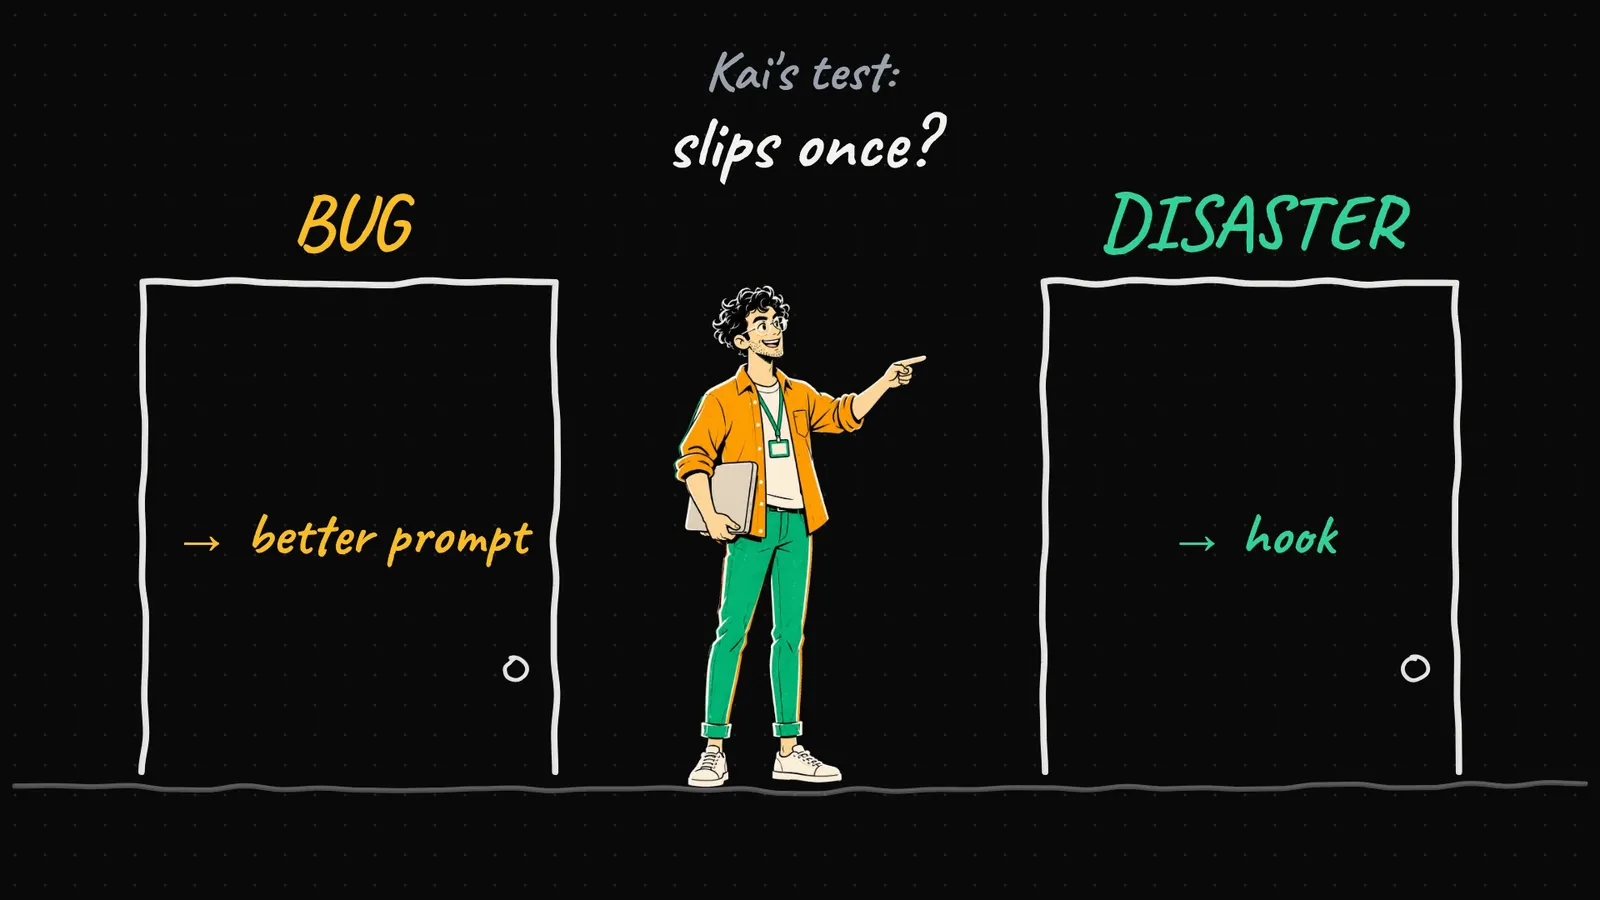
Test Kaia mieści się w dwóch zdaniach. Wyobraź sobie, że reguła raz zawiedzie. Jeśli to błąd, popraw prompt, a jeśli katastrofa, napisz hook.
Jeśli uczysz się do egzaminu Claude Certified Architect Foundations, zapamiętaj z tego odcinka jedno. Gdy pytanie mówi, że reguła musi trzymać zawsze, wzmacnianie system promptu jest pułapką. Wymuś regułę w kodzie.
Skąd to wiem. Szczegóły techniczne pochodzą z dokumentacji Anthropic do Claude Code, Agent SDK i Claude API oraz z przewodnika do egzaminu Claude Certified Architect Foundations w wersji 1.0 z lipca 2026. Drugi agent sprawdził narrację i kod z ekranu względem tych źródeł 6 listopada 2026, a kod powyżej to wersja po tej weryfikacji. Blob, Ada, Kai i historia zwrotu są zmyślone. Agentic Whiteboard i Certified AI Consultant Program są niezależne, niepowiązane z Anthropic i przez Anthropic niepopierane.
ŹRÓDŁA
- A prompt is a request. A hook is a law. Agentic Whiteboard, odcinek 1 (na YouTube jako „Why Your AI Agent Ignores Your System Prompt (Hooks Explained with Animations)”, po angielsku)
- Claude Code: dokumentacja hooków
- Claude Agent SDK: hooki
- Claude Agent SDK: własne narzędzia
- Claude Code: uprawnienia
- Claude API: jak działa użycie narzędzi
- Claude API: obsługa wywołań narzędzi
- Claude API: definiowanie narzędzi
- Claude API: dobre praktyki promptowania
- Przewodnik do egzaminu Claude Certified Architect Foundations, wersja 1.0 (PDF)