Jak zmierzyć wdrożenie Claude Code: okno bazowe, raport po 30 dniach i czyste zamknięcie
Wdrożenie Claude Code mierzę w trzech punktach. Przed pilotem zbieram okno bazowe, bo względem niego liczę każdą późniejszą poprawę. Po 30 dniach pokazuję wynik sponsorowi, który decyduje o skali. Na koniec konfigurację przejmuje zespół klienta i utrzymuje ją beze mnie.
Telemetria Claude Code zaczyna liczyć w dniu, w którym zespół dostaje dostęp. Nie widzi tygodni sprzed startu. Punkt odniesienia musisz więc zebrać sam: z repozytorium, z CI i z krótkiej ankiety. Poniżej opisuję, jak to robię: co zbieram przed pilotem, co mierzę w trakcie, co pokazuję po miesiącu i co zostawiam klientowi.
Mam odznakę Claude Partner Badge, Claude Code, wydaną przez Anthropic. Jej osiem kursów obejmuje etapy pracy z klientem, a wśród materiałów są konfiguracje telemetrii. Ścieżkę kończy capstone oparty na scenariuszu. Odznaka nie jest egzaminem ani partnerstwem. Osobno opisałem, jakie etapy wdrożenia obejmuje ta ścieżka i czego nie potwierdza.
Dlaczego okno bazowe zbieram przed pilotem
Każdą poprawę, którą pokażesz zarządowi, porównujesz ze stanem sprzed pilota. Spadek czasu cyklu PR o 20% wymaga liczby, od której liczysz te 20%. Bez niej nie powiesz też, ile godzin zespół odzyskał. Stanu sprzed pilota nie odtworzysz z pamięci zespołu. Bez niego porównujesz pomiar z wrażeniem.
Wrażenie potrafi mieć przeciwny znak. METR przeprowadził randomizowane badanie na danych z lutego do czerwca 2025 roku. 16 doświadczonych programistów open source wykonało 246 zadań we własnych repozytoriach. Przy zadaniach, w których mogli używać AI, potrzebowali o 19% więcej czasu. Przed badaniem liczyli, że AI przyspieszy ich o 24%. Po badaniu nadal sądzili, że AI przyspieszyło ich o 20%. METR nazywa ten wynik obrazem AI z początku 2025 roku w jednym środowisku. Nie mówi on, jak wypadnie twój zespół.
W lutym 2026 METR opisał drugi pomiar i uznał go za zawodny sygnał. Coraz więcej programistów odmawiało udziału, bo nie chcieli pracować bez AI. Po rozmowach z uczestnikami METR uważa za prawdopodobne, że AI przyspiesza ich dziś bardziej niż rok wcześniej. Własne dane nazywa jednak bardzo słabym dowodem na skalę tej zmiany. Pokazuję wykres obu pomiarów METR razem z przedziałami ufności w tekście o mojej pracy z agentami.
Dla wdrożenia płynie stąd jedna zasada: odczucie zespołu nie zastąpi pomiaru, a pomiar bez punktu odniesienia nic nie mówi. Gdy masz obie liczby, rozmowa o zwrocie robi się krótsza. Wcześniej pisałem, jak rozmawiać z CFO o portfelu metryk zamiast jednej liczby ROI.
Co zebrać przed pilotem i przez ile czasu
Większość danych o dostawie leży już w historii Git, CI i systemu zgłoszeń. Te liczby policzysz wstecz, nawet jeśli nikt ich dotąd nie śledził. Ankiety wstecz nie zrobisz. Dlatego wysyłam ją, zanim zespół dostanie pierwszą licencję.
| Metryka | Definicja | Źródło |
|---|---|---|
| Czas realizacji zmiany (DORA) | Od commita w kontroli wersji do wdrożenia na produkcję. | Git i pipeline wdrożeń |
| Częstotliwość wdrożeń (DORA) | Liczba wdrożeń w okresie albo czas między nimi. | Pipeline wdrożeń |
| Odsetek nieudanych zmian (DORA) | Udział wdrożeń, które wymagają natychmiastowej interwencji, na przykład wycofania albo poprawki. | Incydenty i wycofania |
| Czas cyklu pull requesta | Od otwarcia PR do merge'a, osobno czas do pierwszej recenzji. | Platforma Git |
| Ankieta zespołu | Pięć pytań o konkretne zadania z ostatniego tygodnia. | Formularz przed startem |
| Koszt bazowy | Obecne licencje narzędzi i godziny zespołu na zadaniach, które obejmie pilot. | Faktury i ewidencja czasu |
Trzy pierwsze wiersze to definicje DORA. Czas cyklu PR i ankietę dodaję sam, bo tam spodziewam się pierwszych zmian. Okno bazowe biorę co najmniej tak długie jak pilot. Przy pilocie na 30 dni to cztery do sześciu tygodni historii. Krótsze okno łapie przypadek, na przykład tydzień z dużym wydaniem albo urlopy połowy zespołu.
Porównujesz tylko wtedy, gdy grupa i definicje się nie zmieniają. Mierzę tych samych ludzi na tych samych repozytoriach. DORA radzi stosować swoje metryki do jednej aplikacji albo usługi naraz i ostrzega przed mieszaniem zespołów. Ostrzega też przed prawem Goodharta. Ogłoś metrykę celem, a zespół nauczy się ją podbijać.
Ankietę układam wokół konkretnych zadań. W maju 2026 METR opublikował ankietę wśród 349 pracowników technicznych, przeprowadzoną od lutego do kwietnia. Według METR badani często myślą w kategoriach szybkości. METR spodziewa się, że zmiana szybkości zwykle zawyża zmianę wartości pracy. Przypomniał też, że w badaniu z 2025 roku uczestnicy przeszacowali wpływ AI na czas zadań średnio o 40 punktów procentowych. Pytam więc o rzeczy, które da się sprawdzić: ile zadań czekało na recenzję, co zespół odkłada i gdzie traci czas.
Koszt bazowy ma dwie części: dzisiejsze wydatki i prognozę. Dokumentacja Anthropic podaje średnią z wdrożeń firmowych. To około 13 dolarów na programistę za aktywny dzień i 150 do 250 dolarów na programistę miesięcznie. Ta sama strona radzi zacząć od małej grupy pilotażowej i zebrać własną linię bazową przed szerszym startem. Średnia z rynku nie zastąpi twojej.
Co mierzyć w trakcie pilota
Claude Code eksportuje metryki i zdarzenia przez OpenTelemetry. Włączasz to zmienną CLAUDE_CODE_ENABLE_TELEMETRY=1 i wybierasz eksportery. W pilocie ustawiam to w managed settings, czyli w pliku zasad wdrażanym na maszyny grupy pilotażowej. Wtedy cała grupa wysyła dane do jednego kolektora. Repozytorium nie włączy telemetrii, bo Claude Code ignoruje te zmienne w ustawieniach projektu.
{
  "env": {
    "CLAUDE_CODE_ENABLE_TELEMETRY": "1",
    "OTEL_METRICS_EXPORTER": "otlp",
    "OTEL_LOGS_EXPORTER": "otlp",
    "OTEL_EXPORTER_OTLP_PROTOCOL": "grpc",
    "OTEL_EXPORTER_OTLP_ENDPOINT": "http://collector.example.com:4317",
    "OTEL_RESOURCE_ATTRIBUTES": "team.id=payments,cohort=pilot"
  }
}
Zmienna OTEL_RESOURCE_ATTRIBUTES dokleja własne atrybuty do każdej metryki i zdarzenia. Atrybut cohort oddziela grupę pilotażową od reszty firmy. Dokumentacja wymienia osiem metryk:
| Metryka | Co liczy |
|---|---|
| claude_code.session.count | Rozpoczęte sesje |
| claude_code.lines_of_code.count | Zmienione linie kodu, dodane i usunięte |
| claude_code.pull_request.count | Pull requesty utworzone przez Claude Code |
| claude_code.commit.count | Commity utworzone przez Claude Code |
| claude_code.cost.usage | Koszt sesji w USD |
| claude_code.token.usage | Tokeny według typu i modelu |
| claude_code.code_edit_tool.decision | Akceptacje i odrzucenia edycji plików |
| claude_code.active_time.total | Aktywny czas pracy, bez bezczynności |
Zdarzenia dają więcej szczegółów, na przykład claude_code.user_prompt, claude_code.tool_result i claude_code.api_request. Treść promptów jest domyślnie ukryta. Zanim ktoś ją włączy, ustal z działem bezpieczeństwa, co ma trafiać do kolektora. Metryki kosztu dokumentacja nazywa przybliżeniem. W raporcie koszt biorę więc z rozliczeń.
Firmy na planie Team albo Enterprise mają też panel analityki w claude.ai, dostępny dla administratorów i właścicieli. Pokazuje aktywnych użytkowników dziennie, sesje i odsetek przyjętych sugestii. Gdy administrator GitHub zainstaluje aplikację Claude, dochodzą metryki wkładu w publicznej becie. Porównują scalone pull requesty z kodem pisanym z Claude Code i bez niego. Anthropic nazywa je celowo ostrożnymi, czyli zaniżonymi. Organizacja z Zero Data Retention widzi tylko metryki użycia. Na planie Enterprise dane dzienne na użytkownika zwraca Enterprise Analytics API. Plan Team takiego API nie ma. Organizacje na Claude API mają własny panel w Claude Console, a dane dzienne na użytkownika pobierają przez Claude Code Analytics API.
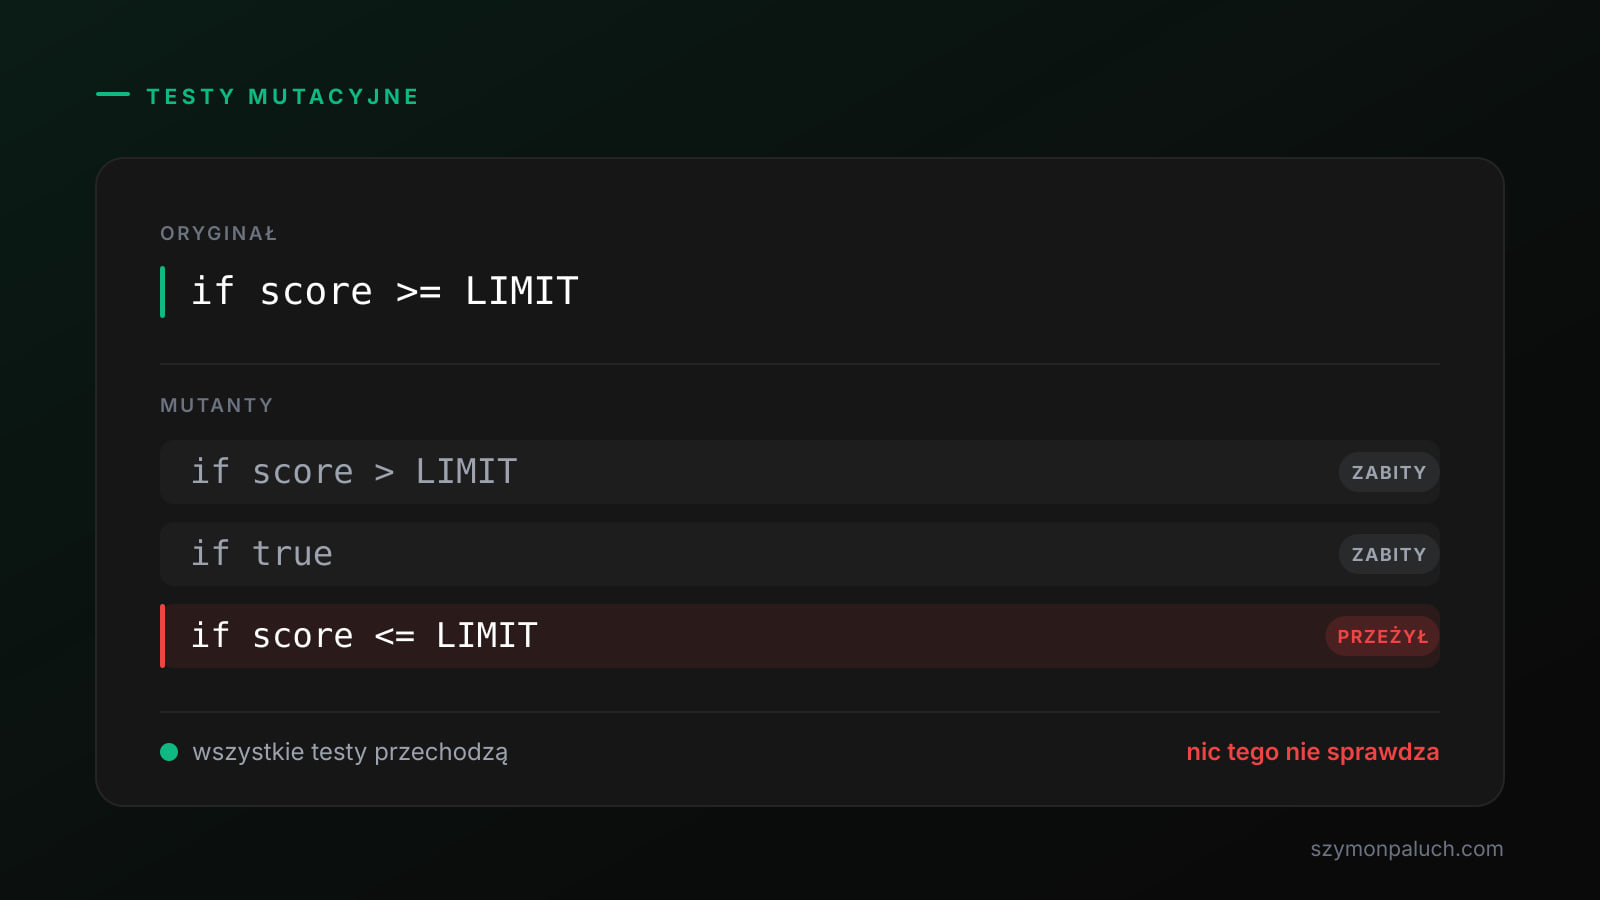
Linie kodu i commity mierzą aktywność. O wartości mówią niewiele. Agent może dopisać dużo kodu i testów, które przechodzą bez sprawdzania czegokolwiek. Dlatego obok telemetrii trzymam metryki z okna bazowego. Gdy testy pisze agent, zmierz testami mutacyjnymi, czy nowe testy łapią celowo wprowadzone błędy.
To robię na co dzień: doradzam przy strategii AI i buduję agentów, którzy przeżywają demo.
Raport po 30 dniach i kto musi go usłyszeć
Po miesiącu zbieram wynik na jednej stronie. Ma cztery części:
- • Dostawa: porównuję te same metryki na tych samych ludziach co w oknie bazowym.
- • Koszt: biorę kwotę z rozliczeń i dzielę ją przez liczbę aktywnych programistów.
- • Adopcja: pokazuję aktywnych użytkowników, sesje i odsetek przyjętych edycji.
- • Zespół: wysyłam tę samą ankietę drugi raz i dokładam trzy cytaty oraz listę blokad.
Na raporcie musi być sponsor wykonawczy. To on decyduje o budżecie i o kolejnych zespołach. Bez niego raport staje się przeglądem statusu, a decyzja przesuwa się o tygodnie. Zapraszam też lidera technicznego, osobę z bezpieczeństwa i przyszłego championa.
Raport kończy się jedną z trzech decyzji: skalujemy, przedłużamy albo kończymy. Warunki każdej zapisuję przed startem pilota. Przedłużenie ma sens tylko z nazwanym pytaniem, na które odpowiedzą kolejne tygodnie. Ten krok odpowiada bramce po pilocie w pięciu etapach, z których każdy kończy się decyzją go albo no-go.
Przykład hipotetyczny, na okrągłych liczbach. W oknie bazowym mediana czasu od otwarcia PR do merge'a wynosi dwa dni. Przed startem ustalamy próg. Skalujemy, jeśli mediana spadnie o co najmniej 20%, a odsetek nieudanych zmian nie wzrośnie. Przy mniejszym spadku przedłużamy o miesiąc i badamy recenzje. Bez spadku kończymy.
The Agentic Architect
Praktyczne wzorce, case studies, rozbiory projektów agentowych i nowinki o AI. Zero spamu, raz w tygodniu.
Dostaniesz jednego maila z prośbą o potwierdzenie. Wypiszesz się jednym kliknięciem. Polityka prywatności
Czyste zamknięcie: konfigurację przejmuje zespół klienta
Zamknięcie jest czyste, gdy zespół klienta zmieni konfigurację beze mnie. Przekazuję trzy rzeczy. Pakiet konfiguracji z numerem wersji. Osobę z nazwiskiem, która go utrzymuje. Krótki runbook.
Pakiet to plugin Claude Code. Trzymam go w repozytorium marketplace, którym zarządza zespół klienta. Plugin może zawierać skille, komendy, agentów, hooki i serwery MCP. Pole version w plugin.json trzyma użytkowników na tej wersji, dopóki jej nie zmienisz. Wpis w marketplace może też wskazać konkretny commit przez pole sha.
Wersje serwerów MCP przypinam w samym pluginie. Komenda, która uruchamia serwer, dostaje dokładny numer pakietu zamiast najnowszego. Dokumentacja zależności pluginów opisuje to samo ryzyko dla pluginów, które zależą od innych pluginów. Bez ograniczenia wersji zależność przechodzi na każde nowe wydanie. Gdy takie wydanie zmieni nazwę narzędzia MCP, z którego korzysta twój plugin, plugin przestaje działać u każdego, kto go zaktualizuje. Taka zależność może mieć zakres wersji, na przykład ~2.1.0. Managed settings z kluczami extraKnownMarketplaces i enabledPlugins instalują marketplace i plugin na każdej maszynie.
W repozytoriach zostają pliki CLAUDE.md. Dokumentacja radzi trzymać każdy poniżej 200 linii. Claude traktuje CLAUDE.md jako kontekst, więc nie wymusza tych zasad. Zakazy idą więc do managed settings, na przykład do permissions.deny, albo do hooka PreToolUse.
Champion to osoba z zespołu klienta, wpisana z nazwiska do runbooka. Uzupełnia CLAUDE.md, gdy Claude powtórzy błąd, recenzja wyłapie brak wiedzy o kodzie albo nowa osoba potrzebuje tego samego kontekstu. Wydaje też nowe wersje pluginu. Ten sam warunek stawiam przed warsztatem, bo bez właściciela wyniku repozytorium ze szkolenia umiera w drugim tygodniu.
Runbook mieści się na dwóch stronach. Opisuje, jak wydać nową wersję pluginu i kto zatwierdza nowy serwer MCP. Mówi, dokąd trafia telemetria i jak cofnąć zmianę.
Test zamknięcia przychodzi po moim odejściu. Champion wydaje wersję 1.1 pluginu bez konsultanta i nic się nie psuje.
Jeśli chcesz przejść ten cykl z pomocą z zewnątrz, opis współpracy przy wdrożeniach AI w zespole klienta pokazuje modele pracy i sposób rozliczenia.
Zanim zespół dostanie pierwszą licencję, zrób trzy rzeczy. Wyślij ankietę. Zapisz w jednym dokumencie definicje metryk z tabeli. Wpisz raport po 30 dniach do kalendarza sponsora.
Najczęstsze pytania
Jak długie powinno być okno bazowe przed pilotem Claude Code?
W mojej metodzie co najmniej tak długie jak pilot. Przy pilocie na 30 dni to cztery do sześciu tygodni historii z Git, CI i systemu zgłoszeń. Ankietę wyślij przed pierwszą licencją, bo ankiety wstecz nie zrobisz.
Jakie metryki Claude Code eksportuje przez OpenTelemetry?
Osiem: liczbę sesji, zmienione linie kodu, pull requesty i commity utworzone przez Claude Code, koszt, tokeny, decyzje o edycjach plików i aktywny czas. Ich nazwy zaczynają się od claude_code, na przykład claude_code.session.count.
Kto powinien być na raporcie po 30 dniach pilota?
Sponsor wykonawczy, bo to on decyduje o budżecie i skali. Do tego lider techniczny, osoba z bezpieczeństwa i champion, który przejmie konfigurację.
Kto widzi panel analityki Claude Code?
Na planach Team i Enterprise widzą go w claude.ai administratorzy i właściciele. Metryki wkładu wymagają też aplikacji Claude na GitHubie i nie działają przy Zero Data Retention. Organizacje na Claude API mają osobny panel w Claude Console, dostępny dla ról z uprawnieniem UsageView.
Czy repozytorium może włączyć telemetrię Claude Code?
Nie. Claude Code ignoruje zmienne eksportera OpenTelemetry w plikach .claude/settings.json i .claude/settings.local.json repozytorium. Telemetrię włączasz w managed settings albo każdy programista ustawia ją u siebie w powłoce lub w ~/.claude/settings.json.
ŹRÓDŁA
- Claude Code: Monitoring (OpenTelemetry)
- Claude Code: Track team usage with analytics
- Claude Platform: Claude Code Analytics API
- Claude Platform: Analytics APIs
- Claude Code: Manage costs effectively
- Claude Code: Deploy managed settings
- Claude Code: Manage plugins for your organization
- Claude Code: Plugin manifest reference
- Claude Code: Plugin dependencies
- Claude Code: How Claude remembers your project (CLAUDE.md)
- DORA: software delivery performance metrics
- METR: Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity (10 lipca 2025)
- METR: We are Changing our Developer Productivity Experiment Design (24 lutego 2026)
- METR: Measuring the Self-Reported Impact of Early-2026 AI on Technical Worker Productivity (11 maja 2026)