Gemini 4 Argon: cena API i odpowiedź na milion tokenów
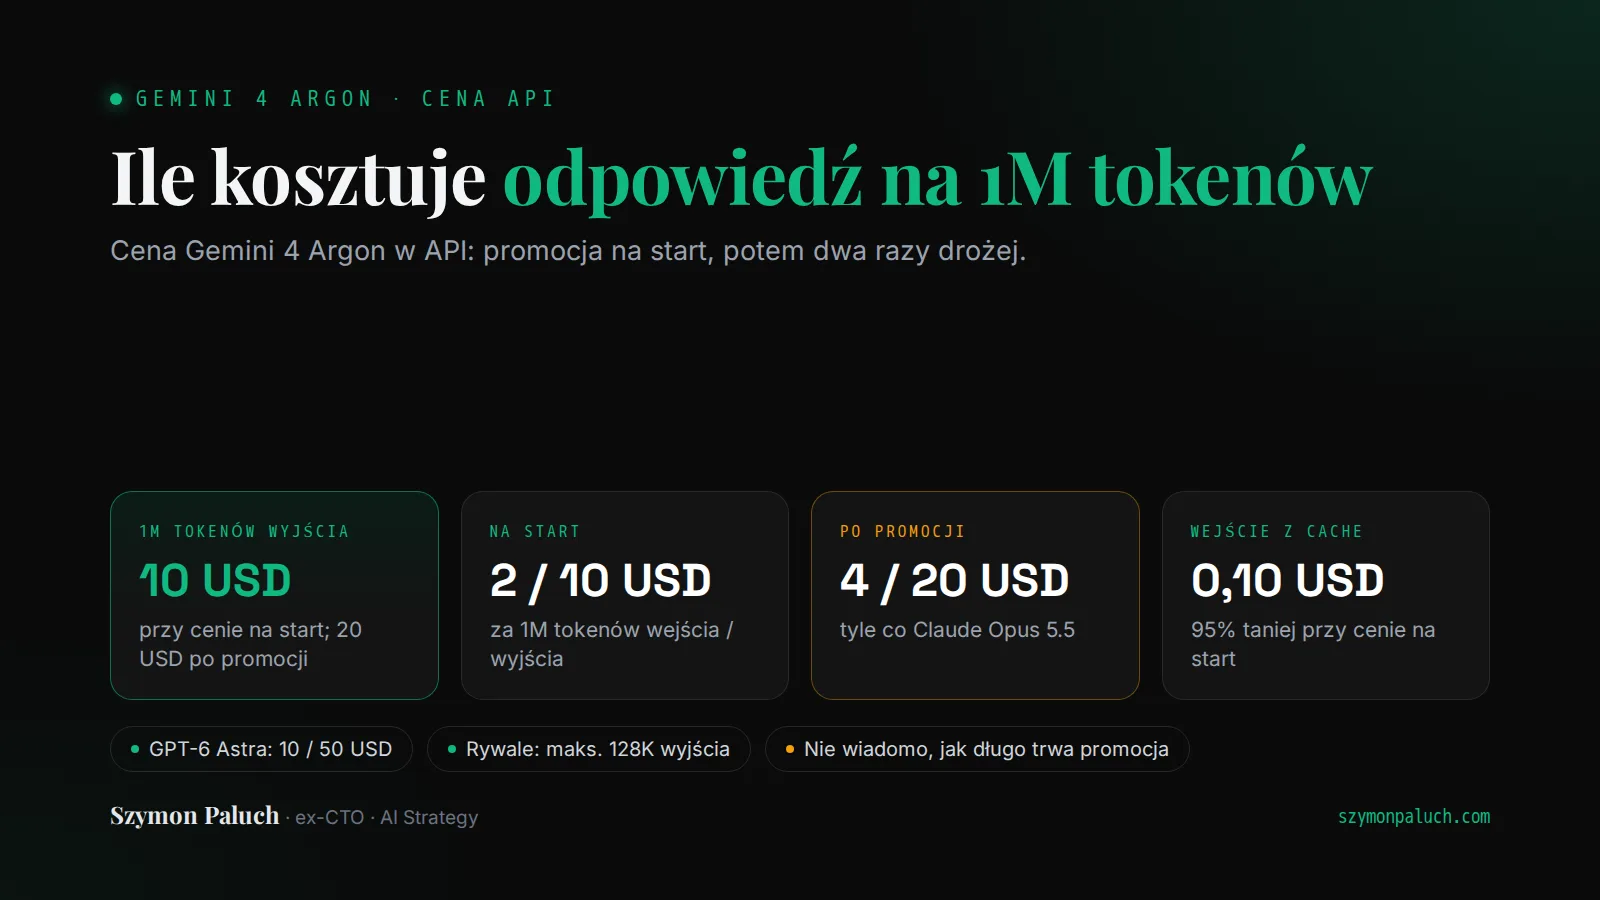
Cena API Gemini 4 Argon na start to 2 USD za milion tokenów wejściowych i 10 USD za milion wyjściowych. Tokeny wejściowe z cache mają 95% zniżki, więc kosztują 0,10 USD za milion. Po okresie wprowadzającym stawki wzrosną do 4 i 20 USD, ale Google nie podało kiedy. Jedna odpowiedź Argona może mieć do miliona tokenów. Za same tokeny wyjściowe takiej odpowiedzi zapłacisz więc 10 USD dziś i 20 USD po promocji.
Wyceniam klientom projekty agentów AI, więc z zapowiedzi Google biorę dwie liczby: ile kosztuje odpowiedź, która wykorzysta cały nowy limit, i kto ją potem sprawdzi. Argona nie testowałem. Nie jest jeszcze ogólnie dostępny, więc liczę z cennika.
Benchmarki, przypadki użycia i harmonogram opisuję w przeglądzie ogłoszenia i tego, co z niego wynika dla firm. Tutaj zostaję przy pieniądzach.
Ile kosztuje Gemini 4 Argon w API?
Google podało dwie ceny. Wprowadzająca to 2 USD za milion tokenów wejściowych, 10 USD za milion wyjściowych i 95% zniżki na tokeny z cache, czyli 0,10 USD. Docelowa to 4 i 20 USD. Przypis z tą drugą ceną nie podaje daty i nic nie mówi o cache. Promocja na Gemini 3.8 Flash ma w cenniku wpisany koniec, 31 grudnia 2026, a przy Argonie takiej daty nie ma.
| Model | Wejście | Wejście z cache | Wyjście | Maks. wyjście (tokeny) |
|---|---|---|---|---|
| Gemini 4 Argon, cena wprowadzająca | 2 | 0,10 | 10 | 1 mln |
| Gemini 4 Argon, po okresie wprowadzającym | 4 | 0,20, jeśli zniżka 95% zostanie | 20 | 1 mln |
| Gemini 3.1 Pro Preview (prompt do 200 tys. tokenów) | 2 | 0,20 plus przechowywanie | 12 | 65 536 |
| Gemini 3.8 Flash (promocja do 31.12.2026) | 0,75 | 0,075 plus przechowywanie | 3,75 | 65 536 |
| Claude Opus 5.5 | 4 | 0,20 (zapis 5) | 20 | 128 tys. (300 tys. w Batch API, beta) |
| Claude Fable 5.1 | 10 | 0,25 (zapis 12,50) | 50 | 128 tys. |
| GPT-6 Astra (prompt do 272 tys. tokenów) | 10 | 1 (zapis 12,50) | 50 | 128 tys. |
Po promocji najbliżej Argona stoi Claude Opus 5.5, który kosztuje dokładnie tyle samo: 4 i 20 USD, z tokenami z cache po 0,20 USD. GPT-6 Astra i Claude Fable 5.1 kosztują 10 i 50 USD. VentureBeat zauważa, że w cenie wprowadzającej Argon kosztuje jedną piątą ceny GPT-6 Astra. Po promocji wychodzi 40%.
W ofercie OpenAI cenę Argona na start ma GPT-6.1 Sol: 2 i 10 USD w API. Po promocji Argon będzie od niego dwa razy droższy. Cały cennik OpenAI po DevDay, od GPT-6 Luna po plany ChatGPT Pro, rozpisałem w osobnym tekście.
Ile kosztuje jedna odpowiedź na milion tokenów?
Google podniosło limit tokenów wyjściowych do miliona, z wcześniejszych 64 tys. Obecne modele tekstowe Gemini 3.x mają w dokumentacji limit 65 536 tokenów. GPT-6 Astra, Claude Opus 5.5 i Claude Fable 5.1 kończą na 128 tys. tokenów. Google uzasadnia zmianę rozumowaniem. Model z takim zapasem może w jednym przebiegu wygenerować setki tysięcy tokenów, głębiej pomyśleć i rozwiązać trudny problem za jednym razem.
Rachunek jest prosty. Milion tokenów wyjściowych razy 10 USD za milion daje 10 USD w cenie wprowadzającej, a po promocji 1 mln razy 20 USD, czyli 20 USD. Do tego dochodzą tokeny wejściowe. Przy prompcie 200 tys. tokenów doliczasz 0,2 razy 2 USD, czyli 0,40 USD, a po promocji 0,80 USD. Pełna odpowiedź z takim promptem kosztuje więc 10,40 USD dziś i 20,80 USD później. Po średnim kursie NBP z 30 września (3,8449 zł za dolara) same tokeny wyjściowe to około 38,45 zł dziś i 76,90 zł po promocji.
Uwaga na jedną rzecz. W obecnych modelach Gemini tokeny myślenia liczą się do limitu i Google rozlicza je jak tokeny wyjściowe. Dla Argona tej zasady jeszcze nie opublikowało. Jeśli ją utrzyma, milion tokenów obejmie i rozumowanie, i odpowiedź. Dostaniesz krótszy tekst, a zapłacisz za całość.
Na innych modelach ten sam milion tokenów wyjściowych wymaga wielu wywołań. Claude Opus 5.5 policzy 20 USD, ale potrzebuje co najmniej ośmiu wywołań, bo 1 000 000 podzielone przez 128 000 daje 7,8. W Batch API w wersji beta zejdziesz do czterech, a cena spada tam o połowę. GPT-6 Astra i Claude Fable 5.1 wezmą po 50 USD, też w co najmniej ośmiu wywołaniach. Gemini 3.1 Pro Preview policzy 12 USD, ale przy limicie 65 536 tokenów potrzebuje co najmniej szesnastu. Każde wywołanie wysyła prompt od nowa, więc płacisz za niego kilka razy.
Po promocji Argon i Opus 5.5 kosztują za token tyle samo. Argon zyskuje na tym, że cały wynik powstaje w jednym przebiegu i nie musisz sklejać kawałków.
Co mieści milion tokenów odpowiedzi?
Google nie przelicza tokenów na strony ani na linie kodu, więc liczę z przybliżenia. Przeciętna linia kodu ma kilkadziesiąt znaków, a token to zwykle kilka znaków. Przyjmuję roboczo około 10 tokenów na linię. To moja miara, Google takiej nie podaje, a Twój język i tokenizer dadzą inny wynik.
Przy tej mierze milion tokenów to rząd 100 tys. linii kodu. Cały zmigrowany moduł zmieści się w jednej odpowiedzi, razem z testami. Google pisze, że agenci AI na Argonie przenoszą do Rusta biblioteki liczące dziesiątki tysięcy linii, i taka biblioteka się zmieści. Jądro Zircon, które według Google ma ponad 800 tys. linii, już nie.
Z tekstem jest podobnie. Kilka znaków na token daje kilka milionów znaków, czyli ponad tysiąc stron po 1800 znaków, minus to, co zajmie myślenie. Pełny raport z załącznikami zmieści się z zapasem.
Jedno zastrzeżenie do tej liczby. Vals AI testował Argona przed premierą. Na stronie modelu wpisał limit wyjścia 262 tys. tokenów i z takim ustawieniem puszczał testy. Google w ogłoszeniu pisze o milionie. Nie wiem, skąd ta różnica. Zanim zaplanujesz zadanie na pełny milion, sprawdź limit w dokumentacji API, gdy Argon się w niej pojawi.
Projektujesz albo wdrażasz agentów u klientów? W naszym kolektywie konsultantów AI przygotujesz się do certyfikacji partnerskich dostawców AI i będziesz uczyć się z innymi. Gdy pojawi się pasujące zlecenie, możemy zaprosić Cię do projektu.
Cache z 95% zniżką: kiedy się opłaca?
Przy długich promptach rachunek bardziej zmienia cache niż limit odpowiedzi. Argon daje na tokeny z cache 95% zniżki. Obecne modele Gemini mają 90%, na przykład 0,20 zamiast 2 USD w Gemini 3.1 Pro Preview.
Weź firmową bazę wiedzy: 200 tys. tokenów regulaminów i dokumentacji, które idą na początek każdego promptu. Stu użytkowników zadaje po jednym pytaniu, więc model czyta 100 razy 0,2 mln, czyli 20 mln tokenów.
Bez cache płacisz 20 razy 2 USD, czyli 40 USD w cenie wprowadzającej. Z cache pierwszy prompt kosztuje 0,2 razy 2 USD, czyli 0,40 USD. Pozostałe 99 czyta z cache 19,8 mln tokenów po 0,10 USD, czyli 1,98 USD. Razem płacisz 2,38 USD, czyli o 94% mniej. Po promocji wychodzi 80 USD bez cache i 4,76 USD z cache, jeśli zniżka zostanie.
Co obejmuje ten rachunek? Tylko tokeny wejściowe, bo odpowiedzi liczysz osobno. Zakładam, że każdy z 99 kolejnych promptów trafi w cache. Pomijam opłatę za trzymanie danych w cache, bo Google nie podało jej dla Argona. Gemini 3.1 Pro Preview liczy 4,50 USD za milion tokenów na godzinę, co dla 200 tys. tokenów daje 0,90 USD za godzinę.
| Model | Bez cache | Z cache |
|---|---|---|
| Gemini 4 Argon, cena wprowadzająca | 40,00 | 2,38 |
| Gemini 4 Argon, po promocji (jeśli zniżka 95% zostanie) | 80,00 | 4,76 |
| Gemini 3.1 Pro Preview | 40,00 | 4,36 plus przechowywanie |
| Gemini 3.8 Flash (promocja do 31.12.2026) | 15,00 | 1,64 plus przechowywanie |
| Claude Opus 5.5 (pierwszy zapis do cache na 5 min) | 80,00 | 4,96 |
| Claude Fable 5.1 | 200,00 | 7,45 |
| GPT-6 Astra | 200,00 | 22,30 |
Po promocji Argon i Opus 5.5 wychodzą tu prawie tak samo: 4,76 i 4,96 USD. Cache opłaca się wtedy, gdy wiele promptów zaczyna się od tego samego długiego fragmentu. Tak wygląda baza wiedzy dla stu użytkowników, stały prompt systemowy agenta AI albo te same definicje narzędzi w każdym kroku. Stałą część trzymaj na początku, pytanie użytkownika na końcu. Gdy każdy prompt niesie inny dokument, zniżka niewiele da.
Pułapka ceny wprowadzającej: licz na 4 i 20 USD
Budujesz produkt na Argonie? Wyceniaj go po 4 i 20 USD. Promocja się skończy, a Google nie podało kiedy. Nie wiesz więc, ile miesięcy Twojej umowy z klientem obejmie. Moim zdaniem bezpieczniej założyć, że nie obejmie żadnego.
Po promocji tokeny wejściowe i wyjściowe drożeją dokładnie dwa razy. Twój koszt modelu też wzrośnie dwa razy, o ile cache zachowa zniżkę 95%. Gdyby spadła do 90%, jak w obecnych modelach Gemini, tokeny z cache kosztowałyby 0,40 USD. Przykład z bazą wiedzy kosztowałby wtedy 8,72 USD zamiast 4,76 USD. To mój scenariusz. Google takiej zmiany nie zapowiadało.
Cennik nie mówi też, ile tokenów model zużyje na zadanie. Vals AI, który testował Argona przed premierą, zmierzył to na swoim indeksie Vals Index, po cenach 4 i 20 USD. Średni koszt testu wyniósł 15,68 USD dla Argona i 32,14 USD dla Claude Opus 5.5, choć oba modele mają tę samą cenę za token. Vals mierzył na swoich zadaniach, na Twoich wynik może wyjść inaczej.
The Agentic Architect
Praktyczne wzorce, case studies i nowinki o AI. Zero spamu, raz w tygodniu.
Dostaniesz jednego maila z prośbą o potwierdzenie. Wypiszesz się jednym kliknięciem. Polityka prywatności
Kto przeczyta milion tokenów?
Po promocji milion tokenów wyjściowych kosztuje 20 USD. Inżynier, który ma przeczytać 100 tys. linii wygenerowanego kodu, spędzi nad nimi wiele dni, a każdy z tych dni kosztuje więcej niż cała odpowiedź modelu. Moim zdaniem tu leży prawdziwy koszt długiej odpowiedzi. Milion tokenów, których nikt nie sprawdził, to ryzyko w systemie klienta.
Google też tego nie pomija. Migracje do Rusta z zapowiedzi przechodzą audyt automatyczny i ręczny, testy w emulacji i przegląd, zanim trafią na produkcję. Google nie pisze, że już tam są.
Dobry wzorzec daje przykład libgav1, dekodera wideo Google. Agenci AI na Argonie wzięli istniejący port w Ruście i zastąpili 32 tys. linii kodu SIMD. Google opisuje wynik dwoma faktami, które da się zmierzyć: obraz na wyjściu jest identyczny, a dekoder działa 2,7 raza szybciej od wcześniejszego portu w Ruście. Punktem odniesienia jest ten port, bo do wersji w C++ dekoder według Google tylko się zbliżył. Żadnego z tych faktów nie sprawdzasz, czytając kod linia po linii. Tak wygląda warunek akceptacji dla długiej odpowiedzi.
Ustal go, zanim poprosisz o milion tokenów. Mogą to być testy, zgodność wyników ze starym systemem albo pomiar czasu. Drugi model, który przeczyta wynik i go zatwierdzi, niewiele dowodzi. Osobno opisałem prawdziwy błąd, którego nie wyłapałaby zgoda trzech agentów AI, i kontrolę, która go odrzuca.
W budżecie całego projektu proporcja wygląda podobnie. Pokazałem to w wycenie, w której kontrola i utrzymanie agenta AI po starcie potrafią w skali roku przebić koszt budowy.
Czego jeszcze nie wiadomo o cenie Argona?
Zapowiedź zostawia kilka luk i każda z nich może zmienić Twój rachunek.
- Jak długo potrwa okres wprowadzający. Przypis mówi tylko, że kiedyś wygaśnie.
- Czy tokeny z cache zachowają 95% zniżki przy cenie 4 USD. Przypis wymienia tylko tokeny wejściowe i wyjściowe. Kwotę 0,20 USD liczę przy założeniu, że zniżka zostanie. VentureBeat przyjmuje to samo założenie i też to zaznacza.
- Ile Argon będzie kosztował w Batch API. Inne płatne modele Gemini mają tam 50% zniżki, a dla Argona Google tej ceny nie podało.
- Czy prompt powyżej 200 tys. tokenów dostanie wyższą stawkę. Gemini 3.1 Pro Preview bierze wtedy 4 USD za milion tokenów wejściowych i 18 USD za milion wyjściowych.
- Ile Google weźmie za trzymanie danych w cache.
- Jak Google rozliczy tokeny myślenia. W obecnych modelach Gemini to tokeny wyjściowe, wliczone w limit.
- Jak model będzie się nazywał w API. W dokumentacji Gemini API Argona jeszcze nie ma.
- Czy „1M” to 1 000 000 czy 1 048 576 tokenów.
Nie wiadomo też, kiedy płatni klienci API dostaną model. Google podaje tylko, że stanie się to jak najszybciej. Zebrałem osobno, kto dostanie Argona pierwszy i co wiadomo o jego dostępności w Polsce i w UE.
Co policzyć, zanim Argon trafi do API
- Przelicz budżet projektu po 4 i 20 USD. Tokeny z cache licz po 0,20 USD, a w wariancie ostrożnym po 0,40 USD.
- Sprawdź w logach, jaka część promptu powtarza się między wywołaniami. Od tego zależy, ile zyskasz na cache.
- Zdecyduj, ile tokenów wyjściowych dopuszczasz na zadanie. W obecnych modelach Gemini limit
max_output_tokensobejmuje też tokeny myślenia. - Spisz warunek akceptacji dla długiej odpowiedzi, zanim o nią poprosisz.
Gdy dostaniesz dostęp, puść na Argonie swój zestaw prawdziwych zadań. Cały rachunek podziel przez liczbę zadań zamkniętych poprawnie i porównaj z modelem, którego używasz dziś.
Źródła i data sprawdzenia
- Google: Gemini 4 Argon, ogłoszenie z cennikiem i przypisem o cenie po promocji
- Gemini API: cennik modeli
- Gemini API: tokeny myślenia i max_output_tokens
- Gemini API: karta modelu Gemini 3.1 Pro Preview
- Anthropic: cennik modeli Claude
- Anthropic: przegląd modeli Claude i limity wyjścia
- OpenAI: cennik API
- OpenAI: karta modelu GPT-6 Astra
- Vals AI: strona modelu Gemini 4 Argon (limit wyjścia 262 tys. w testach)
- Vals AI: Vals Index z kosztem testu
- VentureBeat: Google unveils Gemini 4 Argon
Stan na 1 października 2026.