Gemini 4 vs GPT-6 Astra vs Claude: co mówi tabela benchmarków Google
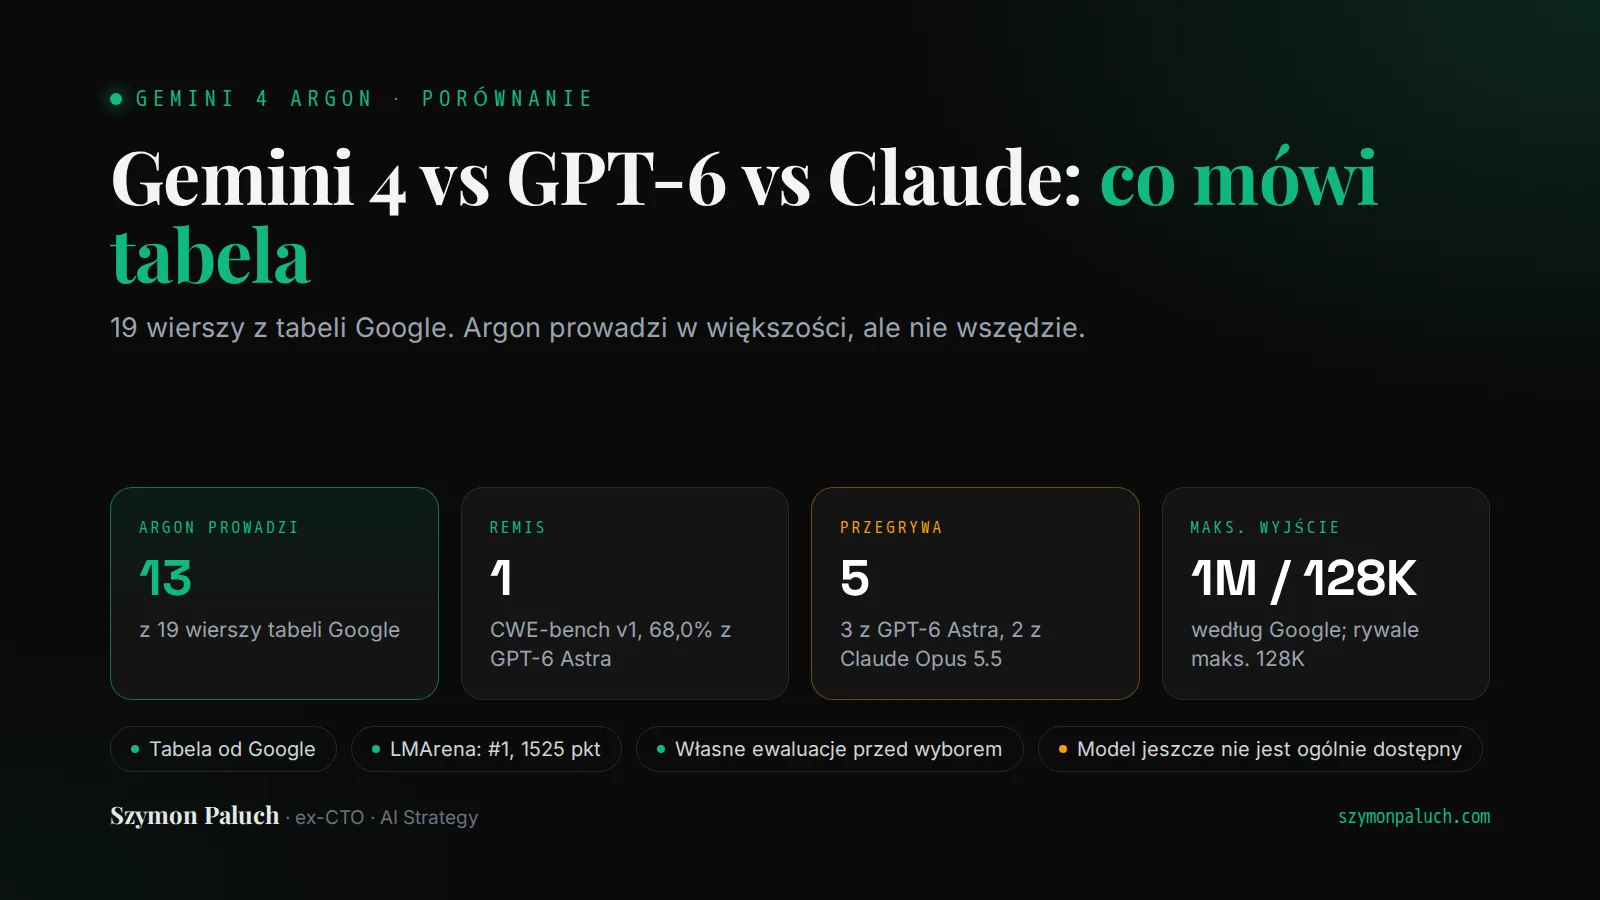
Gemini 4 Argon ma najlepszy wynik w 13 z 19 wierszy tabeli, którą Google pokazało na premierę. W jednym remisuje z GPT-6 Astra. W pięciu najlepszy jest rywal: trzy razy GPT-6 Astra, dwa razy Claude Opus 5.5. W dwóch z tych wierszy Argon jest ostatni z czterech modeli. To liczby podane przez Google, a Argon nie jest jeszcze ogólnie dostępny.
Porównuję cztery modele: Gemini 4 Argon od Google, GPT-6 Astra od OpenAI oraz Claude Fable 5.1 i Claude Opus 5.5 od Anthropic. Dalej piszę krótko: Argon, Astra, Fable 5.1 i Opus 5.5. Argon nie jest jeszcze ogólnie dostępny, a ja go nie testowałem, więc czytam tabelę Google i porównuję ją z tabelami właścicieli benchmarków.
Dla porządku: zdałem egzamin Claude Certified Architect Foundations, a moja firma ma status OpenAI Select Partner. Dlatego przy każdej liczbie piszę, kto ją podał i co mierzy.
Resztę ogłoszenia, czyli dostępność, limit odpowiedzi i przykłady z samego Google, opisałem w przeglądzie tego, co Google ogłosiło 30 września.
Pełna tabela Google: 19 wierszy, cztery modele
Tabela ma 19 wierszy, ale 18 benchmarków, bo GraphWalks zajmuje dwa wiersze: do 128 tys. tokenów oraz od 256 tys. do 1 mln. Liczę wiersze. Wygrana to najwyższy wynik w wierszu, a remis to wynik równy najlepszemu rywalowi. Gdy policzysz benchmarki, wyjdzie 12 wygranych, 1 remis i 5 porażek. Tak samo liczy VentureBeat.
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | Najlepszy wynik |
|---|---|---|---|---|---|
| Praca z wiedzą | |||||
| Vals Index | 68,9% | 63,1% | 65,8% | 67,0% | Argon |
| AutomationBench | 51,3% | 41,4% | 31,4% | 42,5% | Argon |
| Vals Finance Agent v2 | 65,4% | 53,5% | 58,9% | 58,6% | Argon |
| Harvey's Legal Agent Benchmark | 19,6% | 5,4% | 6,7% | 3,8% | Argon |
| Kodowanie agentowe | |||||
| DeepSWE v1.1 | 77,9% | 74,1% | 67,4% | 74,2% | Argon |
| FrontierSWE v2 | 55,0% | 65,5% | 56,3% | 62,3% | GPT-6 Astra |
| Vibe Code Bench | 91,9% | 89,6% | 90,3% | 90,3% | Argon |
| Terminal-bench 4.0 | 57,4% | 58,2% | 57,9% | 66,4% | Claude Opus 5.5 |
| Inżynieria ML | |||||
| PostTrainBench | 45,3% | 44,3% | 40,2% | 49,3% | Claude Opus 5.5 |
| Nauka i matematyka | |||||
| Terminal-Bench Science 0.1 | 57,6% | 68,1% | 52,6% | 63,3% | GPT-6 Astra |
| LABBench 2 | 88,8% | 85,4% | 68,6% | 73,1% | Argon |
| RiemannBench | 76,0% | 72,0% | 65,6% | 69,6% | Argon |
| Długi kontekst | |||||
| GraphWalks, do 128 tys. (BFS, F1) | 99,7% | 98,7% | 91,4% | 90,6% | Argon |
| GraphWalks, 256 tys. do 1 mln (BFS, F1) | 84,2% | 71,8% | 65,0% | 66,8% | Argon |
| Obsługa komputera | |||||
| Agent's Last Exam (odsetek zaliczeń) | 39,5% | 34,2% | brak | 38,2% | Argon |
| OSWorld-2.0 (zbiór offline, wynik częściowy) | 69,2% | 72,6% | brak | brak | GPT-6 Astra |
| Rozumienie multimodalne | |||||
| Chartography | 71,6% | 71,0% | 46,2% | 66,3% | Argon |
| LVBench | 91,7% | 87,5% | 79,7% | 83,7% | Argon |
| Cyberbezpieczeństwo | |||||
| CWE-bench v1 | 68,0% | 68,0% | 58,0% | 67,0% | Remis: Argon i GPT-6 Astra |
„Brak” oznacza, że Google nie podało wyniku. Dlatego w OSWorld-2.0 zostają tylko Argon i Astra.
Gdzie Gemini 4 Argon wygrywa
Najmocniej wypada w pracy z wiedzą, gdzie wygrywa wszystkie cztery wiersze. Vals Index łączy zadania z finansów, kodu, prawa i podatków, a każdą branżę waży jej udziałem w PKB USA. Argon ma tam 68,9%, Opus 5.5 67,0%. W AutomationBench od Zapiera prowadzi o 8,8 punktu, w Vals Finance Agent v2 o 6,5.
Druga mocna strona to długi kontekst. W GraphWalks model dostaje graf zapisany jako lista krawędzi i musi go przejść. Gdy kontekst ma od 256 tys. do 1 mln tokenów, Argon wyprzedza Astrę o 12,4 punktu. Przy krótszym przewaga spada do punktu.
Pięć wygranych jest jednak minimalnych. W Vals Index, Vibe Code Bench, krótszym GraphWalks, Agent's Last Exam i Chartography przewaga nie sięga 2 punktów.
Projektujesz albo wdrażasz agentów u klientów? W naszym kolektywie konsultantów AI przygotujesz się do certyfikacji partnerskich dostawców AI i będziesz uczyć się z innymi. Gdy pojawi się pasujące zlecenie, możemy zaprosić Cię do projektu.
Gdzie Gemini 4 Argon przegrywa
W kodowaniu agentowym Argon wygrywa dwa wiersze z czterech. W dwóch pozostałych jest ostatni. W FrontierSWE v2 traci do Astry 10,5 punktu, a w Terminal-bench 4.0 do Opusa 5.5 9 punktów.
W Terminal-Bench Science 0.1 Argon także traci do Astry 10,5 punktu, ale zajmuje trzecie miejsce. Dwie pozostałe porażki są mniejsze. W PostTrainBench agent AI przez 10 godzin dotrenowuje model językowy na jednym GPU i wygrywa tu Opus 5.5, o 4 punkty. W OSWorld-2.0, teście pracy na komputerze, lepsza jest Astra, o 3,4 punktu.
Jedyny remis to CWE-bench v1, test łatania podatności w kodzie: Argon i Astra mają po 68,0%. Rzecznik Google mówił zresztą Reutersowi ostrożniej niż blog. Według niego w głównych testach kodowania i cyberbezpieczeństwa Argon jest porównywalny z Astrą i Opusem.
Kto zbudował benchmarki i kto policzył wyniki
Kto napisał testy? Najczęściej ktoś spoza Google: Vals AI, Zapier, Surge AI czy Harvey. GraphWalks pochodzi nawet od OpenAI. Tyle że o tym, które 18 testów trafi do tabeli, zdecydowało Google.
Ważniejsze jest, kto liczył wyniki, a to Google opisuje w metodologii. W 9 wierszach wszystkie liczby mają według Google pochodzić z publicznych tabel wyników. Argon ma tam 7 wygranych, 1 remis i 1 porażkę. Pięć wierszy Google policzyło samo, dla wszystkich modeli, i Argon wygrywa w nich cztery razy. W ostatnich pięciu uruchomiło tylko Argona, a wyniki rywali wzięło z cudzych tabel lub od producentów. Ciekawe, że właśnie tu Argon przegrywa najczęściej: trzy razy na pięć.
Czterech właścicieli benchmarków, czyli Vals AI, Zapier, Proximal i Collinear AI, ma już Argona w swoich tabelach. Musieli więc dostać go przed premierą. Te liczby uważam za najlepsze, jakie dziś mamy. Część z nich pokazuje też coś, czego brakuje u Google: rozrzut wyniku. W FrontierSWE v2 najgorszy i najlepszy z pięciu przebiegów dzieli od 18 do 20 punktów.
Warunki też nie zawsze są równe. Przy Terminal-Bench Science 0.1 Google dało Argonowi sześć razy więcej czasu na weryfikację. W OSWorld-2.0 Google podaje jego najlepszy z trzech przebiegów, a wynik Astry bierze z bloga OpenAI. A w LVBench Argon oglądał wideo z 1 klatką na sekundę, rywale zaś dostali od 300 do 800 klatek, bo na tyle pozwalało ich API.
Znalazłem też rozbieżności ze źródłami. Google pisze, że wyniki rywali w Terminal-bench 4.0 wzięło z oficjalnej tabeli. Opusa 5.5 tam jednak nie ma, a jego 66,4% zgadza się z wynikiem, który podał sam Anthropic. Z kolei Fable 5.1 dostaje u Google 52,6% w Terminal-Bench Science, choć oficjalna tabela podaje 40,0%. Ta zamiana działa na korzyść rywala. A publiczne tabele Surge AI, na które Google powołuje się przy RiemannBench i Chartography, nie mają jeszcze Argona.
Czego w tabeli nie ma? Modeli spoza czwórki. W CWE-bench v1 właściciel pokazuje remis trzech modeli, a Grok 4.7 wyprzedza Argona po rozstrzygnięciu wynikiem pass@4. Benchmark Harveya lepiej rozwiązują cztery modele Muse Spark od Meta. Vibe Code Bench prowadzi Claude Sonnet 5.5.
Ustawienia potrafią przesunąć wynik o kilkadziesiąt punktów. Anthropic podaje Chartography z narzędziami i wtedy Opus 5.5 ma 89,0%, a Fable 5.1 88,4%. Tabela Google podaje wyniki bez narzędzi. Te same modele mają wtedy 66,3% i 46,2%.
Jest jeszcze harness, czyli pętla agenta AI, jego narzędzia i to, jak zarządza kontekstem. Nawet w CWE-bench każdy model pracuje w innym: Argon w Antigravity, Astra w Codex, Opus 5.5 w Claude Code. Wynik mierzy więc model razem z obudową. Osobno rozpisałem, co harness dokłada do wyniku modelu i co przepisujesz, gdy model zmieniasz.
Arena: pierwsze miejsce z wynikiem 1525
Arena buduje ranking z głosów użytkowników. 30 września jej oficjalne konto ogłosiło, że Argon (High) prowadzi w Text Arena z wynikiem 1525. Na stronie rankingu wynik jest oznaczony jako wstępny („Preliminary”), ma margines ±9 i 4942 głosy. Ranking liczy się z kontrolą stylu. Po sieci krążył też zrzut z liczbą 1533, ale oficjalna liczba to 1525.
Opus 5.5 (High) jest czwarty z wynikiem 1504, a Astry nie ma w pierwszej 25. W Code Arena: WebDev obraz się odwraca. Tu Argon zajmuje ósme miejsce (1679) i przegrywa ze wszystkimi trzema rywalami: Opus 5.5 jest pierwszy (1818), Astra druga (1789), a Fable 5.1 czwarty (1751).
The Agentic Architect
Praktyczne wzorce, case studies i nowinki o AI. Zero spamu, raz w tygodniu.
Dostaniesz jednego maila z prośbą o potwierdzenie. Wypiszesz się jednym kliknięciem. Polityka prywatności
Cena za możliwości: stawka, koszt zadania i długość odpowiedzi
Google podało dwie ceny, startową i standardową. Ile potrwa promocja? Ogłoszenie tego nie mówi. Nie mówi też, czy po niej wejście z cache zostanie o 95% tańsze.
| Model | Wejście | Wejście z cache | Wyjście | Najdłuższa odpowiedź (tokeny) |
|---|---|---|---|---|
| Gemini 4 Argon, cena wprowadzająca | 2 | 0,10 (wyliczone: 95% taniej) | 10 | 1 mln (według Google) |
| Gemini 4 Argon, po okresie wprowadzającym | 4 | nie podano | 20 | 1 mln (według Google) |
| GPT-6 Astra | 10 | 1 | 50 | 128 tys. |
| Claude Fable 5.1 | 10 | 0,25 | 50 | 128 tys. |
| Claude Opus 5.5 | 4 | 0,20 | 20 | 128 tys. |
VentureBeat napisał, że Argon kosztuje jedną piątą ceny Astry. Zgadza się, ale tylko w cenie startowej. Po promocji wychodzi 40%, a cena standardowa Argona zrówna się z ceną Opusa 5.5. Z drugiej strony GPT-6.1 Sol od OpenAI kosztuje dziś tyle, co Argon w promocji. Astra drożeje jeszcze przy promptach powyżej 272 tys. tokenów: wejście kosztuje wtedy dwa razy więcej, wyjście półtora raza.
Sama cena tokena nie mówi, ile zapłacisz za zadanie. Vals AI podaje koszt zadania w Vals Index, a Argona liczy po jego cenie standardowej. Wychodzi 15,68 USD dla Argona, 18,46 USD dla Astry, 28,71 USD dla Fable 5.1 i 32,14 USD dla Opusa 5.5. W FrontierSWE v2 kolejność wygląda inaczej. Tam jedna próba kosztuje według Proximal 98,87 USD na Opusie 5.5, 129,36 USD na Argonie i 1029,65 USD na Astrze. Proximal zaznacza przy tym, że Argon działał w ustawieniu nieprodukcyjnym i rzadziej trafiał w cache.
Druga różnica to długość jednej odpowiedzi. Według Google Argon ma oddawać do 1 mln tokenów. Google pisze o wzroście z 64 tys., a obecne modele Gemini 3.x mają w dokumentacji limit 65 536. Vals AI, który już testował Argona, podaje limit odpowiedzi 262 tys. tokenów i przyjmuje go domyślnie w swoich testach. Rywale kończą na 128 tys. Wyjątkiem jest Opus 5.5 w Batch API, który w wersji beta dochodzi do 300 tys. Przy limicie 128 tys. milion tokenów wymaga co najmniej ośmiu wywołań. A każdą taką odpowiedź ktoś potem musi przeczytać.
Pełny rachunek, razem z cache, znajdziesz w wyliczeniu, ile kosztuje jedna odpowiedź Argona na milion tokenów.
Jak wybrać model dla klienta
Tabela Google pokazuje zadania autorów benchmarków. Twój klient ma swoje. Moim zdaniem wybór modelu zaczyna się od własnego zestawu testów. Cudza tabela podpowie najwyżej, które modele do niego wpuścić.
Zestaw zamrażasz przed pierwszym przebiegiem. Nowy model zostaje tylko wtedy, gdy poprawia wynik na tych samych zadaniach. Tę zasadę opisałem jako miarkę, której nie ruszasz między kolejnymi modelami.
SZEŚĆ KROKÓW PRZED WYBOREM MODELU
- 1. Zbierz 30 do 50 prawdziwych zadań klienta z poprawnymi odpowiedziami.
- 2. Zamroź zadania i sposób oceny, zanim uruchomisz pierwszy model.
- 3. Uruchom każdy model w tym harnessie, którego użyjesz na produkcji.
- 4. Powtórz każde zadanie kilka razy i zapisz rozrzut wyników.
- 5. Licz koszt zadania zamkniętego poprawnie, po cenie standardowej.
- 6. Sprawdź, czy model jest dostępny w API i w regionie klienta.
Argona dodasz do testu, gdy Google otworzy dostęp w API. Zestaw zadań przygotuj już teraz.
Źródła i data sprawdzenia
- Google: ogłoszenie Gemini 4 Argon
- Google DeepMind: metodologia ewaluacji Argona (PDF)
- VentureBeat: Google unveils Gemini 4 Argon
- Reuters: Google announces Gemini 4 flagship AI model
- Arena: wpis o wyniku Argona
- Arena: ranking Text Arena
- Vals AI: Vals Index
- Vals AI: Harvey's Legal Agent Benchmark
- Vals AI: strona modelu Gemini 4 Argon
- Surge AI: tabela wyników Chartography
- Surge AI: tabela wyników Riemann-bench
- Collinear AI: CWE-bench
- Terminal-Bench 4.0: tabela wyników
- Proximal: FrontierSWE
- OpenAI API: GPT-6 Astra
- Anthropic: Claude Opus 5.5 w dokumentacji
- Anthropic: cennik API
- Anthropic: Introducing Claude Opus 5.5
Stan na 1 października 2026.
Najczęstsze pytania
Czy Gemini 4 jest lepszy od GPT-6?
W tabeli Google Gemini 4 Argon wyprzedza GPT-6 Astra w 14 z 19 wierszy, remisuje w jednym i przegrywa w czterech. To wyniki podane przez Google, a Argon nie jest jeszcze ogólnie dostępny. W Code Arena: WebDev GPT-6 Astra stoi wyżej.
Gemini 4 czy Claude: co wybrać?
To zależy od zadań. W tabeli Google Argon wyprzedza Claude Opus 5.5 w 14 wierszach i przegrywa w czterech, między innymi w Terminal-bench 4.0 i PostTrainBench. Opus 5.5 jest dostępny od razu i kosztuje 4 i 20 USD za milion tokenów, tyle co Argon po promocji. Sprawdź oba modele na własnych zadaniach.
Czy mogę już używać Gemini 4 Argon?
Jeszcze nie. Google udostępnia go najpierw wybranym partnerom programu Fairwind, który prowadzi dla obrońców cyberbezpieczeństwa. Następni będą płatni klienci API i subskrybenci Google AI Ultra. Ogłoszenie nie podaje daty.