Model, który nie generuje tekstu. Co Jev zwraca zamiast zdań
TypeSafe wypuściło 15 września 2026 model, który nie pisze ani jednego słowa. Zadajesz mu typowane pytania o dane, dostajesz wartość i rozkład prawdopodobieństwa. Puściłem go na własnym blogu: 372 wywołania, 0,1185 USD. Poniżej co zmierzył, gdzie moje pytanie okazało się bezużyteczne i czym to przegrywa z klasyfikatorem, którego wytrenujesz w jedno popołudnie.
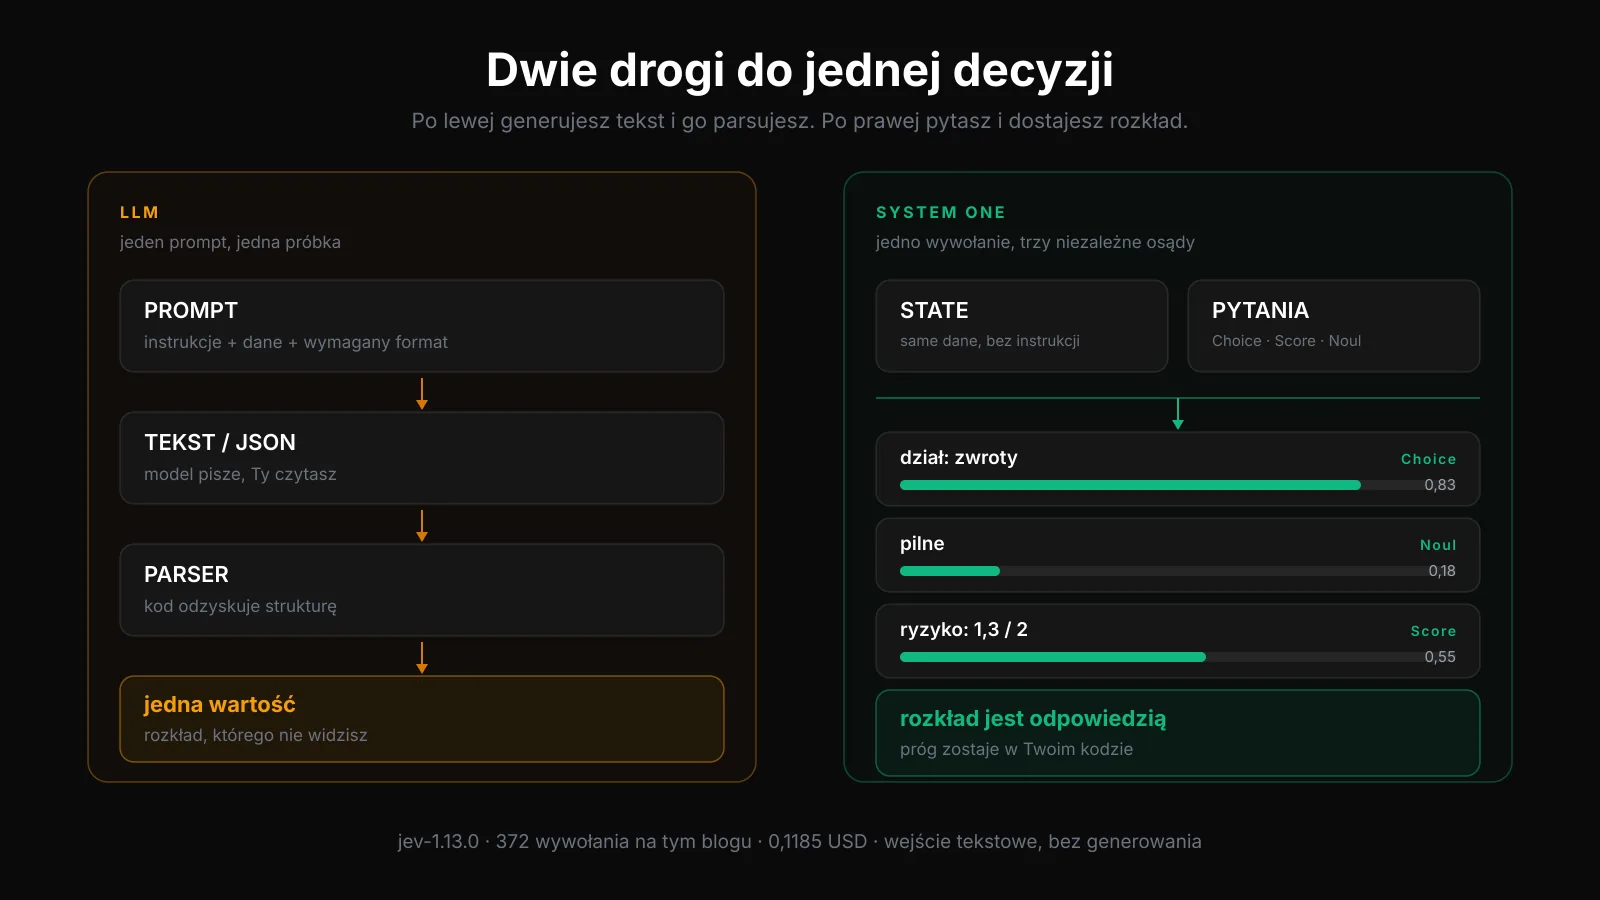
Jeżeli Twój kod prosi model o JSON-a, żeby potem wyciągnąć z niego jedną wartość, płacisz za generowanie tekstu, którego nikt nie przeczyta. Jev jest odpowiedzią na dokładnie tę sytuację: przyjmuje dane i listę typowanych pytań, odsyła wartości z rozkładem prawdopodobieństwa i nie produkuje po drodze ani jednego zdania. To realna różnica architektoniczna, a nie chwyt marketingowy. Jest też młodsze niż większość gałęzi w Twoim repo i w jednym wymiarze wypada gorzej, niż sugeruje strona produktowa.
Model nazywa się jev-1.13.0, a klasę, do której należy, TypeSafe nazwało System One. Nazwa pochodzi od Kahnemana: szybkie, automatyczne osądy zamiast powolnego rozumowania. Wszystkie liczby w tym tekście pochodzą albo z dokumentacji dostawcy, albo z mojego własnego przebiegu na tym blogu, i przy każdej piszę, z czego dokładnie wynika. Cena i limity są z docs.typesafe.ai. Dostawca sam zaznacza, że limity zapytań mogą się zmienić bez zapowiedzi.
Zastrzeżenie, od którego zaczynam, bo zmienia sposób czytania reszty: produkt wystartował 15 września 2026, na razie w early access, z listy oczekujących. Ma dwa dni, jednego dostawcę, brak opublikowanej krzywej kalibracji i brak nazwanych klientów. Wszystko poniżej opisuje, jak działa i co zmierzyłem, a nie rekomendację, żeby postawić na tym ścieżkę płatności.
Czym jest model System One
Model językowy uczono przewidywać kolejny token. Cokolwiek chcesz z niego wydobyć, wychodzi jako tekst, a Ty odzyskujesz z tego strukturę. Jev uczono czegoś innego: zwracać decyzję i prawdopodobieństwo. Dokumentacja nazywa to podejście RLCD, uczenie ze wzmocnieniem pod skalibrowane decyzje, i stawia obok RLHF dla czatów oraz RLVR dla modeli rozumujących. Nie ma w tym warstwy generującej. Nie da się go poprosić o wyjaśnienie, bo nie ma z czego go zbudować.
Przestrzeń odpowiedzi definiujesz Ty, trzema typami pytań. Choice wybiera jedną opcję ze zbioru, który podałeś, i zwraca prawdopodobieństwo dla każdej opcji oraz jedną liczbę pewności. Limit to 255 opcji na pytanie. Score ocenia na uporządkowanej skali od 2 do 10 poziomów, które sam opisujesz słowami, i zwraca pozycję na tej skali razem z rozkładem po poziomach. Noul odpowiada na pytanie tak lub nie jedną liczbą od 0 do 1 i nie ma osobnej pewności, bo sama ta liczba jest już rozkładem.
Konsekwencja jest praktyczna: model nie może zwrócić wartości spoza listy, którą mu dałeś. To nie znaczy, że nie może się mylić. Znaczy tylko, że nie musisz nic parsować i nie musisz obsługiwać przypadku, w którym model wymyślił szesnastą kategorię przy piętnastu dozwolonych.
Jak wygląda jedno wywołanie
Żądanie ma trzy pola: state z danymi do oceny, model i mapę questions, w której klucze wybierasz sam. Odpowiedź wraca pod tymi samymi kluczami. Klucz nigdy nie trafia do modelu, jest wyłącznie uchwytem po stronie kodu. Przykład odpowiedzi niżej jest skrócony: pomijam w nim obowiązkowe pole usage z licznikiem tokenów.
{
  "state": { "zgloszenie": "Buty przyszły w złym rozmiarze." },
  "model": "jev-latest",
  "questions": {
    "dzial": {
      "type": "choice",
      "instructions": "Który zespół ma to obsłużyć?",
      "criteria": {
        "zwroty":  "Wymiany, reklamacje, zły towar",
        "wysylka": "Status dostawy, opóźnienia, zgubione paczki",
        "platnosci": "Obciążenia, faktury, problemy z płatnością"
      }
    },
    "pilne": { "type": "noul", "instructions": "Czy sprawa jest pilna?" }
  }
}{
"model": "jev-1.13.0",
"answers": {
"dzial": {
"type": "choice",
"choice": "zwroty",
"confidence": 1.0,
"probabilities": { "zwroty": 1.0, "wysylka": 0.0, "platnosci": 0.0 }
},
"pilne": { "type": "noul", "noul": 0.18 }
}
}Najważniejsza właściwość tej konstrukcji jest niewidoczna w przykładzie z dwoma pytaniami. Wszystkie pytania w jednym żądaniu widzą ten sam stan i są liczone równolegle, w izolacji od siebie. Odpowiedź na jedno nie jest kontekstem dla drugiego. Dorzucenie pytania prawie nie zmienia czasu odpowiedzi, bo stan jest wczytywany raz, a pytania jadą obok siebie. W kucharce dostawcy trzynaście pytań do artykułu o RODO puszczonych jednym wywołaniem wyszło 12,2 raza taniej i 10 razy szybciej niż trzynaście osobnych wywołań, przy identycznych odpowiedziach. Ta sama liczba pojawia się w innym miejscu dokumentacji jako 11,5 raza i 9,6 raza, więc jedna z tych stron jest nieaktualna.
Z tej równoległości wynika sposób pracy, który dokumentacja nazywa najważniejszym pojęciem w całym przewodniku: rozkładaj osąd na atomy. Zamiast pytać „oceń ten pomysł”, pytasz osobno o wielkość rynku, wykonalność i przewagę, a wagi trzymasz w swoim kodzie. Zmiana priorytetu to wtedy zmiana współczynnika, a nie przepisywanie promptu.
Gdzie naprawdę różni się od LLM-a proszonego o JSON
Pierwsze pytanie każdego, kto to buduje, brzmi: po co, skoro mogę włączyć structured output i dostać ten sam enum. Odpowiedź, która się broni, jest węższa niż pitch dostawcy i warto ją znać dokładnie.
Structured output gwarantuje kształt odpowiedzi, a nie jej treść i nie rozkład. Dostajesz jedną wartość spróbkowaną z rozkładu, którego nie widzisz. Możesz go podejrzeć przez logprobs, czyli surowe prawdopodobieństwa kolejnych tokenów. I tu zaczyna się realna granica. OpenAI pokazuje najwyżej 20 alternatyw na pozycję tokenu. API Anthropica nie pokazuje ich wcale. Przy taksonomii na sześćdziesiąt kategorii nie ma więc żadnej drogi do rozkładu po opcjach. Zostaje pytanie tego samego modelu N razy i liczenie, co ile razy wypadło, czyli N wywołań i oszacowanie obarczone własnym szumem.
Jest też kwestia tego, skąd bierze się ta liczba. Prawdopodobieństwo opcji w LLM-ie to prawdopodobieństwo następnego słowa, liczone po słowniku liczącym ponad sto tysięcy tokenów. Ty sam zawężasz je potem do swoich kategorii. Po drodze łapie obciążenia, które nie mają nic wspólnego z Twoim zadaniem. Zheng i współautorzy zmierzyli jedno z nich na dwudziestu modelach i trzech zbiorach testowych. Modele wolą pewne identyfikatory opcji, po prostu litery A/B/C/D, niezależnie od tego, co pod nimi stoi. Etykieta dłuższa o kilka tokenów dostaje inną liczbę niż krótka. A samo wymuszenie formatu przy dekodowaniu przesuwa rozkład względem tego, w co model faktycznie wierzy.
To samo dotyczy najpopularniejszego obejścia, czyli proszenia modelu, żeby ocenił własną pewność w skali od 0 do 1. Ta liczba jest wypowiedzią, nie pomiarem. Model 32-miliardowy pytany o pewność na zbiorze SST-2 wyprodukował osiem różnych wartości, a na czterech zbiorach od 45 do 93 procent masy siedziało w pięciu najczęstszych liczbach. Opisywałem wcześniej, dlaczego taka samoocena rozjeżdża się z rzeczywistą trafnością i co to robi z progiem w kodzie.
Te dwie rzeczy zostają prawdziwe niezależnie od tego, ile warte okaże się RLCD. Po pierwsze, ile opcji da się w ogóle obsłużyć. Po drugie, że rozkład jest liczony po Twoich opcjach, a nie po tokenach. Tylko to przetrwało moją weryfikację.
To robię na co dzień: doradzam przy strategii AI i buduję agentów, którzy przeżywają demo.
Co wyszło na moim własnym blogu
Napisałem trzy skrypty i puściłem je na treści tej strony. Najciekawszy pyta, do którego innego wpisu powinien prowadzić link z danego artykułu. Ten blog ma utrzymywany graf linków wewnętrznych, a pilnuje go bramka w buildzie. Każdy wpis musi mieć co najmniej jedno wejście i jedno wyjście, w obu językach, do tego samego zbioru celów. Bramka pilnuje kształtu grafu. Nie umie powiedzieć, który cel jest właściwy, i to akurat robiłem dotąd ręcznie.
Stanem jest treść artykułu. Opcjami są wszystkie pozostałe wpisy w tym samym języku. Jedno wywołanie szereguje cały katalog. Mam więc darmowy sprawdzian: czy model trafia w linki, które wybrałem wcześniej ręcznie.
| miara | pełny tekst | bez kotwic |
|---|---|---|
| cel nr 1 to istniejący link | 72 / 74 | 71 / 74 |
| istniejące linki w top 5 | 230 / 268 osiągalnych | 207 / 268 osiągalnych |
| średnia pewność | 0,631 | 0,584 |
Kolumna druga jest ważniejsza od pierwszej. Treść wpisu zawiera przecież tekst każdego istniejącego linku. Zdanie „jak pisałem o cichych awariach” podaje modelowi odpowiedź na tacy. Druga kolumna to ten sam przebieg z wyciętymi kotwicami, i dopiero ona jest uczciwą miarą tego przecieku. Trafienie pierwszym wskazaniem spadło o jeden przypadek na 74, trafienia w top 5 o 23 na 268, a średnia pewność o 0,047.
Mianownik to 268, a nie 288, z prostego powodu. Dziesięć wpisów ma więcej niż pięć linków, a ranking zatrzymywał się na piątce, więc reszty i tak nie dało się trafić.
Ciekawsze jest to, czego ten wynik nie znaczy. Oba przebiegi wskazują ten sam najlepszy cel tylko w 45 przypadkach na 74. A w 26 z tych 29 rozbieżności oba wskazania i tak są linkami, które ten wpis już ma. Przeciek zostaje więc wewnątrz zbioru istniejących linków. Przesuwa wskazanie z jednego z nich na drugi.
Jest jeszcze jedna liczba, która mnie uwiera. Polska i angielska wersja tego samego wpisu wskazują ten sam najlepszy cel tylko w 29 przypadkach na 37. Mój niezmiennik wymaga, żeby obie wersje celowały w ten sam zbiór, więc model sam z siebie by go nie utrzymał.
Praktyczny wniosek jest rozczarowujący i wart powiedzenia: dla 37 opublikowanych wpisów to narzędzie nie ma nic do zaproponowania. Ręczny graf już trzyma te cele, które model by wybrał. Wartość jest w momencie publikacji, przy wpisie, który nie ma jeszcze żadnych linków.
Pytanie, które nie zmierzyło niczego
Do każdego wpisu dorzuciłem Noul: czy ten artykuł w ogóle zawiera miejsce, w którym link na zewnątrz pomógłby czytelnikowi. Pomysł był taki, żeby nie wpychać linku tam, gdzie tekst jest samowystarczalny.
Zero z 74 przebiegów zeszło poniżej 0,5. Średnia wyszła 0,871 przy pełnym tekście i 0,891 przy ślepym. Pytanie nie rozróżniło niczego, bo na tak postawione pytanie odpowiedź dla dowolnego artykułu o inżynierii brzmi „tak”. To samo stało się z dwoma Noulami w skrypcie oceniającym jakość tekstów: „czy tytuł dowozi” i „czy jest sprawdzalny dowód” w żadnym z 74 plików nie zeszły poniżej 0,5. Dwa polskie wpisy wylądowały dokładnie na 0,50, a skrypt flaguje dopiero poniżej tej wartości. Raport wypisał „nic nie oflagowano” i to była prawda, tylko bezużyteczna.
Model zachował się poprawnie. Wadliwe było pytanie. To jest koszt, o którym pitch nie mówi: typowana odpowiedź gwarantuje interfejs, nie sensowność. Źle postawione pytanie zwraca liczbę, która wygląda dokładnie tak samo jak liczba użyteczna, i nic w systemie nie zapali się na czerwono. Zebrałem osobno te tryby awarii, w których wszystko kończy się kodem 200, a wynik jest już nieprawdziwy, bo to one kosztują najwięcej czasu przy diagnozie.
Błąd, który wyszedł tylko dlatego, że pytania były dwa
Drugi skrypt bierze zapytania z Search Console i pyta, która strona powinna na nie odpowiadać. Obok pytania Choice o stronę postawiłem Noul: czy ten serwis ma w ogóle stronę, która odpowiada na to zapytanie. Pierwszy przebieg zwrócił coś niemożliwego. Zapytanie „bounded autonomy” trafiło we wpis o dokładnie tym tytule z prawdopodobieństwem 0,93, a pokrycie wyszło 0,26.
Przyczyna była moja. Listę stron wpisałem jako opisy opcji pytania Choice. A opisy opcji widzi tylko to jedno pytanie. Wspólny dla wszystkich pytań jest wyłącznie stan. Drugie pytanie oceniało więc pokrycie, nie mając przed sobą ani jednej strony.
Przeniosłem listę do stanu i liczby się przestawiły. Średnie pokrycie na 36 wspólnych zapytaniach podskoczyło z 0,271 do 0,751. To konkretne zapytanie z 0,26 do 0,95. Przy okazji naprawiło się kierowanie językowe: na tych samych 36 zapytaniach pierwszy przebieg wybrał polski cel 5 razy, a drugi 14. W pełnym, 114-zapytaniowym przebiegu polskich celów było 46.
Warto zobaczyć, co tu zadziałało. Nie bramka, nie test, nie typ. Sprzeczność między dwiema odpowiedziami na to samo. Gdybym zadał jedno pytanie, dostałbym wiarygodnie wyglądający ranking i nie miałbym powodu w niego wątpić. Pewność modelu też by mnie nie uratowała, bo jest liczona z tego samego rozkładu, który był zepsuty. To ten sam mechanizm, przez który ocena wystawiona przez model samemu sobie nie jest dowodem, że wynik jest poprawny. Ratuje drugi, niezależny pomiar.
Czego Jev nie zrobi
Dostawca prowadzi stronę o słabych miejscach modelu i jest na niej uczciwie. Warto ją przeczytać przed, a nie po.
- Nie liczy. Znaki w słowie, wystąpienia frazy, elementy długiej listy. Rozpoznaje kształt odpowiedzi, zamiast zliczać, a błąd rośnie z wielkością liczonej rzeczy.
- Nie porównuje dat. Która wcześniejsza, ile dzieli, czy mieści się w oknie. Gorzej przy mieszanych formatach i przy kwartałach czy okresach rozliczeniowych.
- Nie odtworzysz ze Score realnej wielkości. Wynik 1,3 na skali trzech poziomów to pozycja na opisanej skali, a nie procent ani kwota. Progowanie jest w porządku, rekonstrukcja liczby nie.
- Reprezentacje liczbowe wypadają gorzej niż semantyczne. Pytanie o kolory po nazwach działa lepiej niż po wartościach szesnastkowych.
- Gubi się w nadmiarze. Trafność spada, gdy stan puchnie o treści niezwiązane z decyzją. Limit to 64 tysiące tokenów łącznie na stan i wszystkie pytania, plus drugi, ciaśniejszy: 32 tysiące na stan i najdłuższe pojedyncze pytanie. Ten budżet jest po to, żeby zmieścić wiele pytań, a nie cały dokument.
- Nie jest odporny na wrogie wejście. Stan jest traktowany jak dane, nie jak coś potencjalnie wrogiego. Tekst napisany tak, by przestawić klasyfikację, potrafi ją przestawić. To samo w sobie wyklucza używanie go jako jedynej bramki bezpieczeństwa.
- Czyta dosłownie. Zakresy, przeczenia i warunki domyślne bierze wprost. Ich diagnostyka jest dobra: jeśli patrząc na złą odpowiedź tłumaczysz, co miałeś na myśli, to tłumaczenie jest brakującą częścią pytania.
Do tego wejście jest wyłącznie tekstowe. Bez obrazów, dźwięku i wideo. I rzecz oczywista, a jednak warta napisania: model nie napisze odpowiedzi, podsumowania, kodu ani uzasadnienia. Dokumentacja pisze wprost, że da się go do tego zmusić łańcuchem Choice'ów, że wyjdzie źle i że będzie bardzo wolno.
Czym to przegrywa z nudnymi rozwiązaniami
Tu robi się niewygodnie dla pitchu. Centralna obietnica brzmi: skalibrowane prawdopodobieństwa bez Twoich etykiet. Problem w tym, że kalibracja przestaje być przewagą w momencie, w którym masz kilkaset oznaczonych przykładów. Wtedy wystarczy skalowanie temperaturą. To jedna liczba dopasowana do Twoich danych, dwadzieścia linijek kodu, i na większości zbiorów działa zaskakująco dobrze. Nie masz etykiet? Osiem przykładów na klasę, czyli jedno popołudnie pracy, wystarczyło metodzie SetFit, żeby na benchmarku jej autorów dorównać modelowi few-shot wielokrotnie od niej większemu, i to bez promptów. A przy stabilnej liście kategorii możesz wytrenować własny mały klasyfikator. Model klasy ModernBERT ma 149 milionów parametrów. Nie trenujesz go od zera, tylko pobierasz gotowy i dostrajasz na swoich kategoriach, co schodzi w minutach na jednej karcie. Potem nie płacisz za wywołanie.
Przy szeregowaniu sprawa jest jeszcze wyraźniejsza. Pytanie Score zadane osobno każdemu kandydatowi to jedno przejście modelu na kandydata. Dokładnie tak działa reranker, tylko że tu płacisz za tokeny. Alternatywa liczy reprezentacje wektorowe raz, offline, i potem tylko przeszukuje bazę. Jeżeli Twoje pytanie brzmi „posortuj korpus po podobieństwie”, typowane pytanie jest opakowaniem na coś, co istnieje od lat i kosztuje mniej.
Jest też sprawa dowodów. Dostawca publikuje tablicę wyników, w której etykiety odniesienia powstają jako uśrednienie odpowiedzi dwóch dużych modeli generatywnych. Dla produktu sprzedawanego jako alternatywa dla osądu LLM-a to jest koło: „trafność” na tej tablicy znaczy zgodność z konsensusem dwóch LLM-ów, a nie poprawność. Warto przy tym pamiętać, że sędzia oparty na LLM-ie ma własne, zmierzone obciążenia, choćby systematyczną preferencję dla tej odpowiedzi, którą porównuje jako pierwszą, więc etykieta odniesienia też nie jest neutralna. Na tych samych danych Jev ląduje w środku stawki: 67,8 procent zgodności uśrednione po czterech zadaniach, co do dziesiątej części punktu tyle samo co sonnet 5. Powyżej czterech innych modeli, z haiku 4.5 na 53,6, i poniżej opusa 5 na 73,1 oraz najlepszego wyniku tablicy, 74,1. Zależnie od zadania od 61,7 do 76,0 procent. Druga oś tej samej tablicy pokazuje, o co naprawdę chodzi: 0,0004 USD i 0,4 sekundy na przypadek, osiem razy taniej i dwadzieścia pięć razy szybciej niż druga najtańsza i druga najszybsza konfiguracja. Pitch dotyczy stosunku ceny do jakości, a nie inteligencji, i tak należy go czytać. Hasło o zerowych halucynacjach też jest twierdzeniem o typach, nie o prawdzie: Choice nie wymyśli opcji spoza listy, ale może wskazać złą.
Nie znalazłem też w dokumentacji ani jednego wykresu pokazującego, czy deklarowane 0,9 faktycznie oznacza dziewięć trafień na dziesięć. Żadnej standardowej miary kalibracji. Żadnej publikacji o RLCD. To jest centralna obietnica tego produktu i jednocześnie jedyna, której nie da się dziś sprawdzić inaczej niż na własnych danych.
Kiedy to ma sens
Reguła, którą zostawiam sobie po tym przebiegu, jest prosta. Sięgam po typowane pytanie, gdy zbiór odpowiedzi jest zamknięty i większy niż dwadzieścia, gdy potrzebuję rozkładu po tych odpowiedziach, a nie jednej wartości, gdy nie mam oznaczonych danych i nie opłaca mi się ich robić, i gdy wynik konsumuje kod, a nie człowiek. Cztery warunki naraz, nie jeden z czterech.
Masz trzy kategorie i tysiąc oznaczonych przykładów? Wygrywa własny, mały klasyfikator. Pytanie jest otwarte i nie da się wypisać odpowiedzi? Wygrywa LLM. Sortujesz duży zbiór po podobieństwie? Wygrywają wektory liczone raz. Zostaje wąski, ale realny środek: dużo zamkniętych osądów o tych samych danych, próg w kodzie i eskalacja do człowieka poniżej progu. To jest dokładnie ta konstrukcja, którą opisywałem jako cztery poziomy eskalacji, od zwykłego oznaczenia sprawy po zatrzymanie agenta, tylko z prawdopodobieństwem zamiast twardej reguły na wejściu.
Koszt tego eksperymentu to 372 wywołania, 2,82 miliona tokenów wejściowych i 0,1185 USD. Jeden przebieg wyrzuciłem po drodze jako błędny. Cena jest na tyle niska, że przestaje być argumentem w dyskusji, i właśnie dlatego warto przenieść uwagę na pytanie, które faktycznie decyduje: czy Twój osąd da się zamknąć w liście opcji, i czy masz gdzie odesłać przypadki, w których model nie jest pewien. Jeżeli nie masz drugiego, próg pewności jest tylko ozdobą.